ChatGPT 的图像生成能力更新到 2.6 之后(以官方发布口径为准),外贸团队用它出产品图和配图越来越顺手;短视频工具(如 CapCut 的教程生态)也让批量做字幕视频变成了零门槛。但客户那边的验收标准没跟着 AI 降级——图片里一个参数写错、字幕里一个单位打错,采购商照样拿来砍价甚至退货。好看救不了错误。
生成内容的错法:三种,两种致命
AI 生成的产品图和字幕视频,错误集中在三个位置:
| 错法 | 例子 | 危险级 |
|---|---|---|
| 参数错 | 图上标"功率 850W"实际是 800W;字幕写错型号后缀 | 致命:进合同就是事故 |
| 单位/格式错 | 字幕 mm 写成 cm、包装规格的数量词错位 | 致命:物流与安装事故源 |
| 观感错 | 颜色偏差、光影不真实、比例失真 | 中度:信任损耗但不构成合同事实 |
前两种是事实类错误——AI 生成图片里的文字是它"画"出来的,不是从你的参数表"读"出来的。这一代图像模型生成文字的机制决定了:它看起来像印刷体,可靠性却是手抄体——每一个数字都要当手抄体核对。字幕同理,语音转写或翻译环节对型号、单位这类"低频词"的识别,出错率远高于日常语句。
第三种观感类错误最容易被忽略其对 B2B 的隐性伤害:买家看到光影过于完美的产品图,第一反应 increasingly 是"这是 AI 生成的吧"——生成感本身在消耗专业信任。B2B 语境里,略糙但真实的实拍,信任价值高于完美但虚幻的渲染。
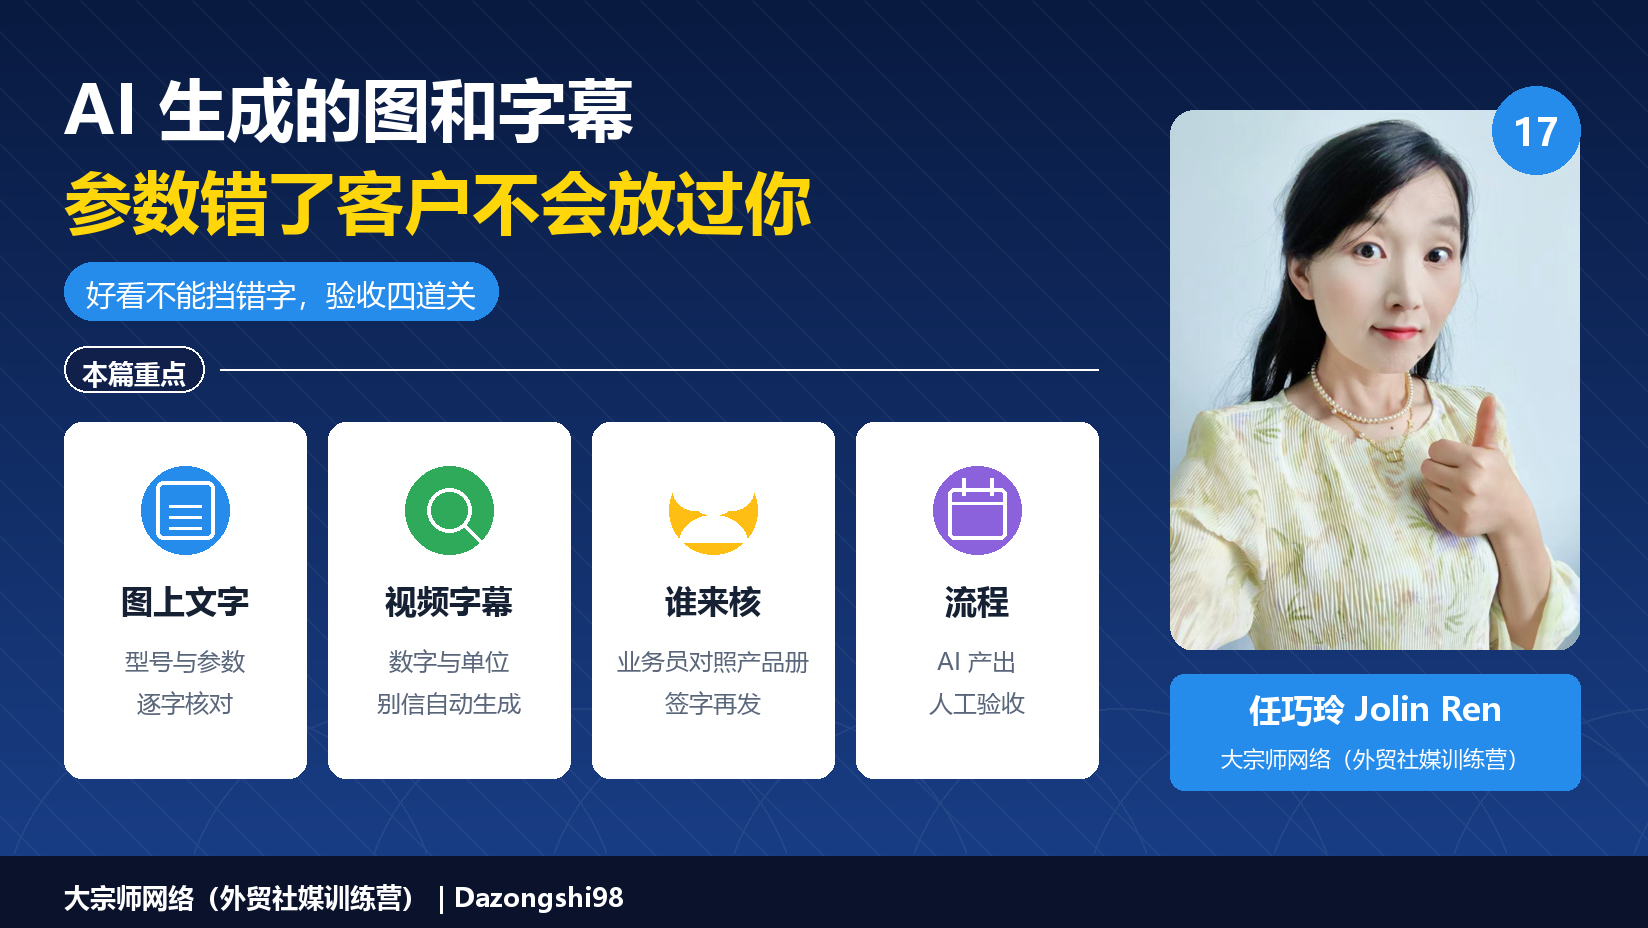
验收流程:三查一存
给生成内容(图+字幕视频)设计一个固定的验收流程,四步:
一查:参数逐个对。 图上和字幕里出现的每一个数字、每一个单位、每一个型号字符,逐个和参数表核对。做法土但有效:参数表开左边、生成图开右边,肉眼逐项过。数字超过 10 个的图,让 ChatGPT 反向帮忙——把图发回给文字模型问"这张图上所有数字是什么"(OCR 式读回),拿读回结果对参数表,漏检率大幅下降。
二查:多画幅一致性。 同一内容发不同平台需要多画幅(横版/竖版/方形),AI 批量出图时每个画幅都是一次独立的生成——横版对了竖版错,是批量生成的高发错误。全画幅逐个过参数,不能"抽查横版,默认竖版同款"。
三查:字幕的技术词。 视频字幕里的型号、单位、标准号(如认证编号)单独拉出来核——这些词在语音转写里是高错区。技术词建议全部人工校,通用语句可以抽检。
一存:验收记录。 过检的内容存档时带一行备注:"参数已核对(核对人/日期)"。这行字在半年后内容复用时(换个平台再发)是保命符——没有这行字的旧内容复用,等于把验收流程重跑一遍。
| 检查对象 | 检查方法 | 责任人 |
|---|---|---|
| 图内参数/文字 | 肉眼逐项 + AI 读回对照 | 内容运营 |
| 多画幅版本 | 全版本逐个过 | 内容运营 |
| 字幕技术词 | 技术词全量人工校 | 内容+技术双签 |
| 验收存档 | 备注"核对人/日期" | 归档人 |
参数进图的安全姿势:少写、写准、靠源文件
降低图内参数错误率的三个设计原则:
少写:图上的参数能不写就不写——参数的权威位置是落地页和规格书,图是吸引力不是档案。图上保留型号+一两个核心卖点数字即可,图越"轻",错的面越小。
写准:必须上图的参数,用"后处理"而不是"生成"——让 AI 生成不带文字的画面,文字用设计工具(或脚本)排上去。生成的文字是画出来的(不可控),排版的文字是打上去的(可控)——这一步流程改造,参数错误率从"听天由命"降到"人为可控"。
靠源文件:所有批量图的参数来源统一成一个源文件(一张参数总表),排版脚本从源文件读数——源头改一处,所有图同步。AI 生成链路里最贵的错误是"改了参数表,五十张旧图还是旧数"——源文件驱动的设计让这种漂移不可能发生。
字幕视频的三道关
字幕类内容的错误分布有自己的规律,三道关卡着过:
| 关 | 检查什么 | 高发错误 |
|---|---|---|
| 转写关 | 语音转文字的准确性 | 型号字母听错(B/D、M/N)、数字连读错 |
| 翻译关 | 中译外语幕的术语 | 单位换算错、行业术语直译 |
| 样式关 | 字幕的呈现 | 换行断在数字中间、遮挡画面关键参数 |
三关里翻译关最容易放过大坑:英文字幕里 "MOQ: 1000 pcs" 被翻译工具处理成 "Minimum quantity: 1000 pieces" 没问题,但处理成 "1000 minimum orders"(语义错位)客户就理解成"最少订一千次"。外贸术语的黑名单式校验(MOQ、OEM、lead time 这些词在任何字幕工具产出里都要人工扫一眼)是字幕出关的最后一道闸。
谁来验收:双人双签的轻量版
验收流程谁来执行?B2B 内容团队的现实方案是"双人双签"的轻量版——不需要专职审核岗,两个角色各管一段:
| 角色 | 负责的检查 | 签什么 |
|---|---|---|
| 内容运营 | 多画幅一致性、字幕样式、观感 | "全版本过检" |
| 技术同事(或最懂产品的人) | 图内参数、字幕技术词 | "参数无误" |
技术签只需要扫参数(一分钟级),但这一分钟是整条流程里密度最高的一分钟——九成的致命错误在这一关被拦。小团队没有专职技术的话,"最懂参数的那个人"兼任——工厂里的老师傅、产品经理都可以。关键不是职级是熟悉度:对参数有肌肉记忆的人,扫一眼就知道 850W 不对劲。
生成内容的工作流:一张流转卡
把整条流程固化成一张卡,贴在内容团队的工作流里:
需求 → 生成(AI 出画面,不带文字)→ 排版(文字从参数源文件读入)→ 双检(内容运营+参数签)→ 存档(备注核对人/日期)→ 发布
流转卡的价值在第二、三环——很多团队的现状是"AI 直接生成带文字的成品图 → 发",跳过了排版和双检。改造顺序建议:先加双检(不改生成方式,先把错误拦住),再改排版(把错误从源头消掉)——先刹车再换发动机,过渡期安全。
大宗师网络的三条判断
第一,AI 生成内容的验收成本是省不掉的"质量税"。 我们给企业做内容流程设计时反复验证一个账:AI 把内容的生产成本降了 70%,但验收环节一分没降——参数核对、多画幅检查、字幕校验,这些动作 AI 越快产出越要仔细做。净效率 = 生产提速 − 验收不变 → 总账仍然是赚的,但验收环节从流程的边角变成了瓶颈。没意识到这一点的团队,会用"AI 出图很快"的速度错觉,跳过验收直接发布——错误内容流出去的速度也跟着快了。
第二,"后排版"是对抗生成不可控的唯一正解。 图像模型生成文字的可靠性问题(这一代模型的共性)不是提示词能解决的——它是生成机制的属性。把文字环节从"生成"挪到"排版",等于把不可控环节换成了可控环节。愿意做这个流程改造的团队,AI 图片才敢进客户交付物;不肯做的,AI 图永远只能停留在内部草稿和社媒配图的安全区。
第三,客户对 AI 内容的宽容度在下降,不是上升。 早期,AI 生成的精美内容还有"新奇加分";现在买家见多了,识别力上来了——"这是 AI 图"的识别本身开始扣信任分。外贸内容策略的AI 用法要跟着调:AI 生成用于内部草稿、选题示意、内部评审,客户可见层的核心素材往"真实感"倾斜(实拍、车间、真实数据截图)。AI 提效生产,真实建立信任——两条腿分工,别让一条腿替代另一条。
什么情况不用全流程验收(反转条件)
- 内容完全不进客户视野——内部培训材料、草稿示意、内部评审用图,验收可缩到抽检。
- 图上零文字零参数——纯氛围配图(背景、概念图)没有事实类错误的载体,观感过关即可。
- 纯人工排版的图(文字部分全走设计工具)——参数从源文件读入的链路本身可控,人工复检从"逐项"降为"抽查源文件"。
- 字幕为纯通用语句(无型号无单位无术语)——转写翻译的低错区,抽检即可。
- 单一画幅单次使用(不批量不复用)——多画幅与复用风险不存在,验收链路缩短。
常见问题
让 ChatGPT 自己检查自己生成的图,可靠吗?
部分可靠。AI 读回图上的数字(OCR 式)是有效的辅助——它读出的和你参数表对不上,至少证明有错。但读回本身也会漏(漏读一个角标),所以读回是"漏检率降低"不是"零漏检"——人工终检不能全撤。
多画幅出图怎么保证一致?
一版定稿再扩版:先精修横版(全参数验收过),再让工具出竖版/方形,扩版后每个版本重过一遍参数——扩版是重新生成不是裁切,一致性不会自动继承。
字幕批量校验有工具捷径吗?
导出字幕文件(SRT 类文本)批量搜技术词(型号、MOQ、单位词表)——文本级搜索比肉眼快十倍。搜出来的每处命中人工核。黑名单词表一次建好,长期复用——这是字幕校验的基建。
旧图里的错误参数已经发出去了,怎么办?
按影响面处理:还没被客户引用的,静默替换;已被客户拿到的(对过报价、进过谈判的),主动告知——"发现宣传物料某参数有误,正确值是 X,以规格书为准"。主动纠错伤面子,被动曝光伤信任——B2B 的长期账算下来,主动永远便宜。
团队没有设计工具,只能纯 AI 生成怎么办?
那就严守使用边界:AI 生成图只做不带关键参数的素材(氛围、背景、概念示意),参数一律留给落地页承载。工具条件不满足时,把内容策略调整到条件满足——纪律补能力的不足,而不是能力不足还硬闯交付区。
本文属于我们 AI 外贸实战培训 这条线(ChatGPT、CapCut 等工具的内容生产):生成内容验收、参数排版分离、字幕校验。训练营里"三查一存"是内容模块的交付动作——学完的团队当天就能把验收流程挂上。不承诺内容效果,交付的是错误不出门的流程。
Dazongshi98
本篇常见问题
让ChatGPT自己检查自己生成的图,可靠吗?
部分可靠。AI读回图上的数字(OCR式)是有效的辅助——它读出的和你参数表对不上,至少证明有错。但读回本身也会漏(漏读一个角标),所以读回是"漏检率降低"不是"零漏检"——人工终检不能全撤。
多画幅出图怎么保证一致?
一版定稿再扩版:先精修横版(全参数验收过),再让工具出竖版/方形,扩版后每个版本重过一遍参数——扩版是重新生成不是裁切,一致性不会自动继承。
字幕批量校验有工具捷径吗?
导出字幕文件(SRT类文本)批量搜技术词(型号、MOQ、单位词表)——文本级搜索比肉眼快十倍。搜出来的每处命中人工核。黑名单词表一次建好,长期复用——这是字幕校验的基建。
旧图里的错误参数已经发出去了,怎么办?
按影响面处理:还没被客户引用的,静默替换;已被客户拿到的(对过报价、进过谈判的),主动告知——"发现宣传物料某参数有误,正确值是X,以规格书为准"。
团队没有设计工具,只能纯AI生成怎么办?
那就严守使用边界:AI生成图只做不带关键参数的素材(氛围、背景、概念示意),参数一律留给落地页承载。工具条件不满足时,把内容策略调整到条件满足——纪律补能力的不足,而不是能力不足还硬闯交付区。