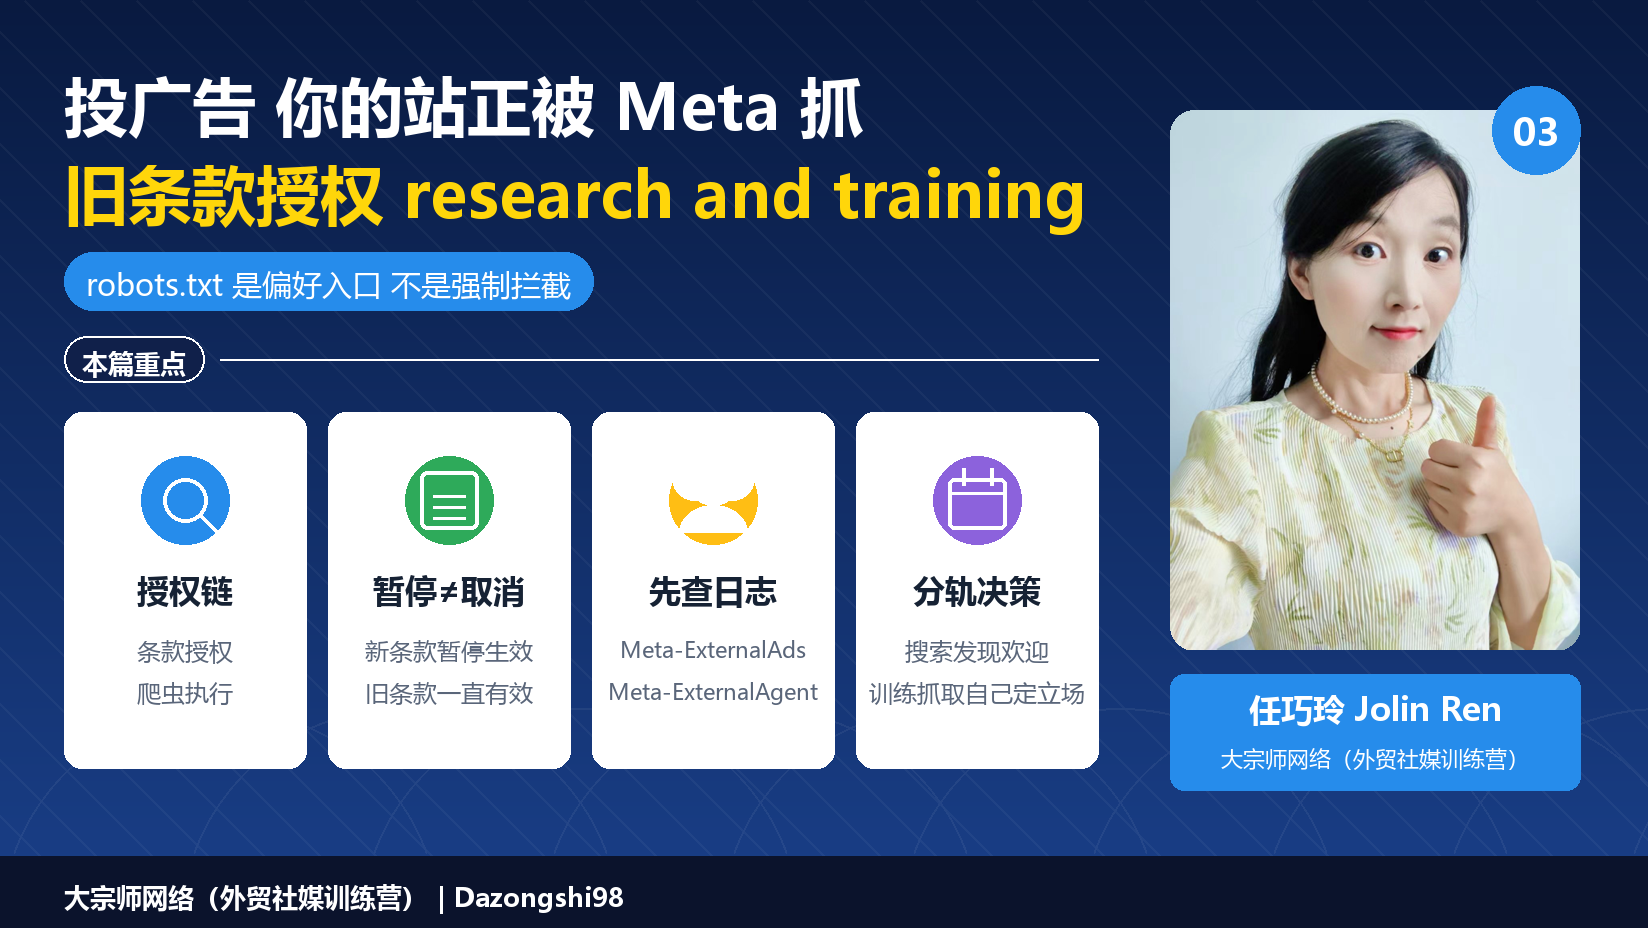
一件大部分外贸企业不知道的事:你在 Meta 投广告的那一刻,现行自助广告条款(2025-08-22 版)就授权 Meta 对你广告指向的域名内容做 "access, index, cache, analyze or crawl"——抓取、索引、缓存、分析,用途白纸黑字写着包含 "research and training"(研究与训练)。你的产品页、规格表、公司介绍,都可能进了 Meta 的语料池。据 Search Engine Journal 2026-11-10 报道,Meta 原定 11 月 20 日生效的新版商业条款已被暂停,但注意:暂停的是新条款,旧条款里的抓取授权一直有效。这不是"Meta 拿到了新授权",是"授权早就在,你没看过"。
先把授权链摆清楚:谁授权了什么
| 层 | 依据 | 授权范围 |
|---|---|---|
| 条款层 | 自助广告条款(现行版) | 对广告主域名内容 access / index / cache / analyze / crawl |
| 用途层 | 同上,原文 | 含 research and training |
| 执行层 | Meta 爬虫文档:Meta-ExternalAds、Meta-ExternalAgent | 实际来抓你站的是这些 User-agent |
| 你的开关 | robots.txt | 内容方表达抓取偏好的入口 |
两个容易读错的地方。第一,"授权"不等于"天天在抓"——授权是可能性,抓取是行为,想知道实际有没有来、来过几次,要查服务器日志,方法在 AI 爬虫日志怎么查 里写过。第二,别把这写成"Meta 偷数据"——条款是签的,写在那里的,争议点只在"多少广告主真的读过这一条"。
robots.txt:唯一的开关,但别高估它
内容方表达偏好的入口是 robots.txt——Meta 的爬虫文档把 Meta-ExternalAds 和 Meta-ExternalAgent 列了出来,robots.txt 里可以按名字放行或拒绝。这是你能做的最正式的一步。
但有三句丑话必须在前面:
- robots.txt 是"表达偏好",不是"强制拦截"。 Search Engine Journal 的报道明确提到,Meta 另有两只爬虫在特定情况下可能不遵守 robots.txt。守规矩是常态,但你的合规姿势不能建立在"它一定守规矩"上。
- 关掉广告爬虫可能影响广告功能。 Meta-ExternalAds 的用途和你广告投放的质量评估相关;一刀切 Disallow,广告侧的代价要自己掂量。广告跑得正欢的企业,先别急着全关。
- 别机械照抄网上的示例。 和你现有的 Googlebot 规则、安全策略放在一起整体看,不能不看现有文件直接覆盖——这是我们在 robots.txt 怎么给 AI 爬虫配规则 里的老规矩,OpenAI 的示例片段也一样,示例是示例,你的文件是你的文件。
投广告的企业,实际该做哪几件事
第一步:查日志,再谈立场。 你的站到底有没有被 Meta-ExternalAds / Meta-ExternalAgent 抓过、抓了哪些页,服务器访问日志里写着。没被抓过,robots.txt 怎么写都是纸面姿势;被抓过,才有真决策要做。
第二步:按用途分轨想清楚。 这是整个 AI 爬虫管理的核心思路:搜索发现类爬虫(决定你能不能被 AI 推荐)和训练类抓取(决定你的内容进不进语料)要分开配置,不能一刀切。这套双轨逻辑在 robots.txt 怎么给 AI 爬虫配规则 里有完整展开,Meta 这两只爬虫归在哪一轨、怎么写,照那张表来。
第三步:秘密不上站。 如果你担心的是技术参数、客户名单、内部资料被抓走——它们本来就不该出现在公开页面上。robots.txt 挡不住人对公开内容的合法访问,权限和保密制度才是这一层的答案。
第四步:配合 CDN 白名单一起查。 有一种更隐蔽的反向问题:robots.txt 放行了,但 Cloudflare 这类 CDN 的 Bot 防御在边缘层直接把合法爬虫 403 掉了——你以为是 Meta 不来,其实是自家门禁拦的。这个坑和诊断方法在 robots 放行了爬虫为什么还不来 里拆过,两件事经常一起发生。
对不投广告的企业,这事也有关
很多人以为这只影响投广告的。两层修正:
一,Meta 的公开内容抓取不只有广告条款一条链路——它的人工智能训练相关爬虫另有名单,同样走 robots.txt 表达偏好。你不在 Meta 投广告,不代表你的公开页面不在任何爬虫的范围内。二,从 GEO 角度说,被优质引擎抓取是好事——ChatGPT、Perplexity 的搜索爬虫决定你能不能出现在 AI 答案里(AI 问答流量怎么接住、llms.txt 是什么 讲的都是怎么"多被抓")。所以别把这次的事读成"AI 爬虫都是坏的"——正确姿势是分轨:欢迎搜索发现,审视训练抓取,两轨分开配,各自出结论。
三条判断
一,暂停的新条款和有效的旧条款是两件事,别在文章和方案里混写;11 月 20 日不再是任何截止日。二,robots.txt 是目前唯一正式的偏好入口,写不写、怎么写,是每个用官网做外贸的企业该自己拍板的事——我们给客户的建议从来是"先查日志、再分轨、后落笔"。三,这条新闻的真正价值不是吓你,是提醒你:你的官网早就是 AI 生态的一部分了——被动挨抓还是主动管理,差的是一次体检。
我不投 Meta 广告,就不用管这事吗?
不是。广告条款只是抓取授权的一条链路,公开页面对各类 AI 爬虫的可见性管理是所有外贸独立站的共同课题。不投广告,你的决策反而简单:按双轨原则,欢迎搜索发现类,训练类自己定立场。
robots.txt 写了 Disallow,Meta 就一定不抓了吗?
不一定。robots.txt 是偏好表达,不是技术强制;报道明确提到 Meta 有爬虫在特定情况下可能不遵守。真正的机密内容靠权限体系,不靠 robots.txt。
怎么确认 Meta 爬虫来过我的站?
查服务器访问日志里的 User-agent 字段,找 Meta-ExternalAds / Meta-ExternalAgent;用 CDN 的在后台看爬虫请求记录。具体步骤见 AI 爬虫日志怎么查。
大宗师网络
大宗师网络 出品 | 杭州大宗师网络科技有限公司 | 大宗师网络(外贸社媒训练营) 外贸独立站的 AI 可见性是门技术活:哪些门该开、哪些该关、怎么验证,我们把它拆成了可执行的规范与检查清单。
本篇常见问题
投Facebook广告,你的官网正在被Meta抓走?
一件大部分外贸企业不知道的事:你在Meta投广告的那一刻,现行自助广告条款(2025-08-22版)就授权Meta对你广告指向的域名内容做"access,index,cache,analyzeorcrawl"——抓取、索引、缓存、分析,用途白纸黑字写着包含"researchandtraining"(研究与训练)。
投广告的企业,实际该做哪几件事?
第一步:查日志,再谈立场。你的站到底有没有被Meta-ExternalAds/Meta-ExternalAgent抓过、抓了哪些页,服务器访问日志里写着。没被抓过,robots.txt怎么写都是纸面姿势;被抓过,才有真决策要做。第二步:按用途分轨想清楚。