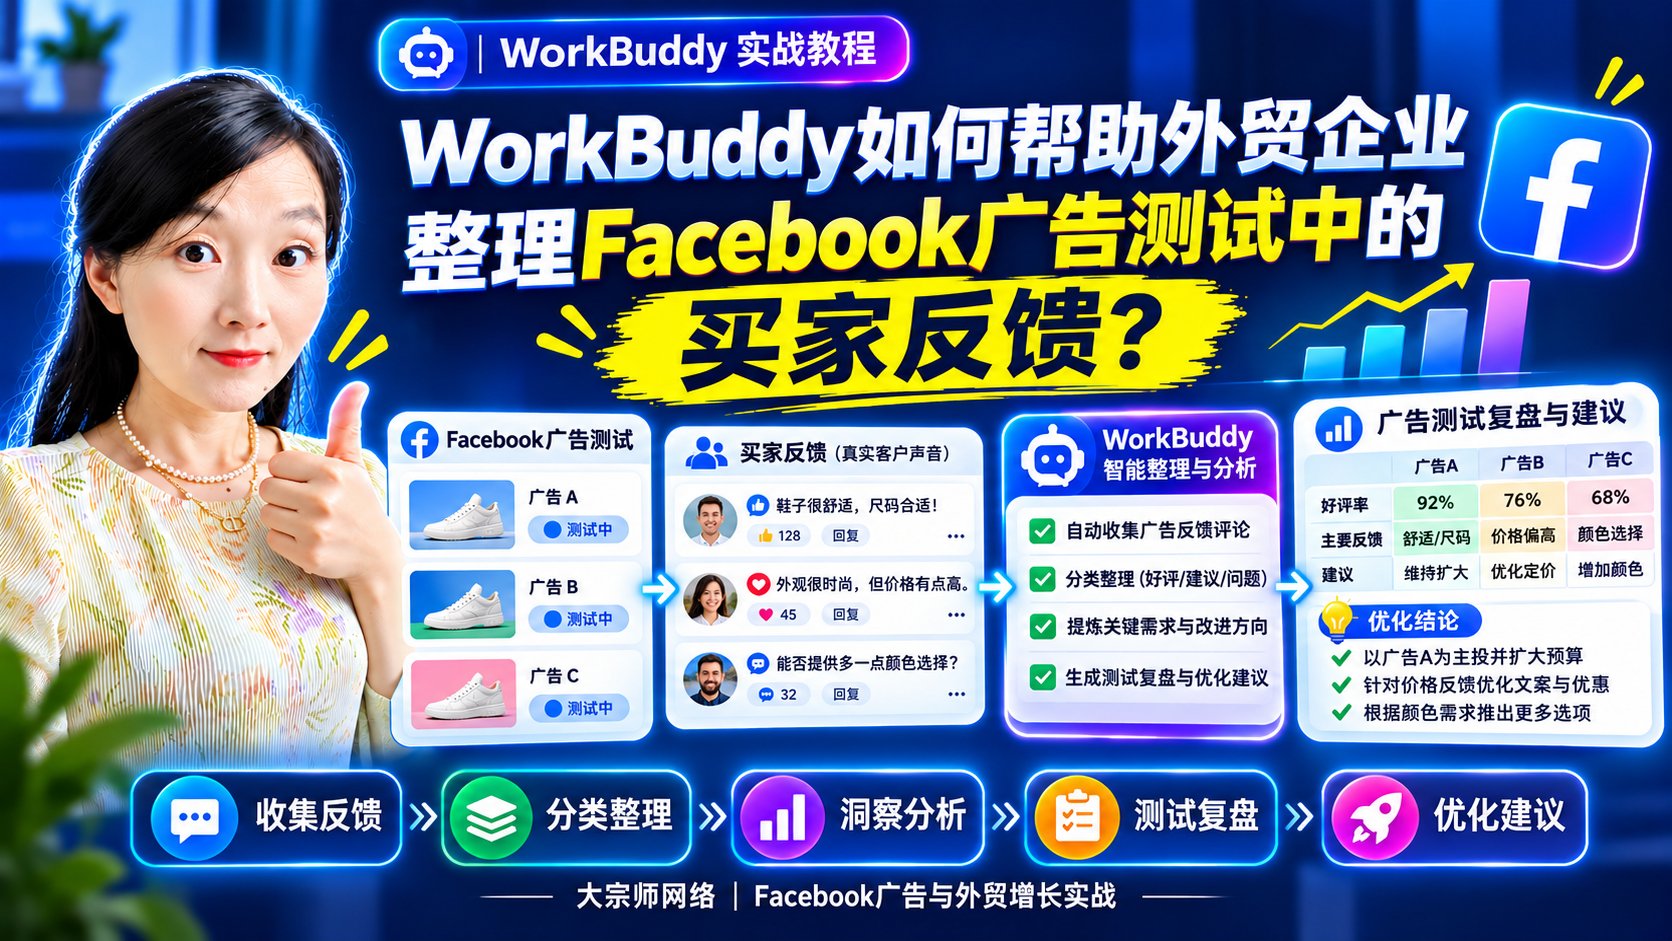
能。广告测试最值钱的产出不是点击率,是买家在评论区、私信和落地页行为里留下的反馈——哪句文案让人停下、哪个参数被反复追问、哪个价格让人犹豫。多数企业把这些反馈当杂音扔掉了,只盯着数据面板。WorkBuddy 的角色是把散落在三处的反馈收进一张结构化表:按反馈类型归档、按广告素材归因、按频次排序,让每一轮测试的结论能积累、能复用,而不是每轮从零开始。
锚点先行:
- 3 处:买家反馈的三个来源——帖子评论区、Messenger 私信、落地页行为(关页位置、表单放弃)
- 5 类:反馈按内容分五类——价格质疑、参数追问、认证与合规、交期物流、无关噪声
- 1 条归因线:每条反馈必须挂回具体广告素材,不能只记「有人问了价格」
- 2 轮:一个素材至少跑 2 轮测试,反馈模式重复出现才算信号,单轮结论是噪声
- 0 次:同一类价格质疑出现在 3 条不同素材下——这不是素材问题,是报价结构问题,改素材零次也修不好
一、反馈为什么值得整理:数据面板告诉你「怎么样」,反馈告诉你「为什么」
广告数据面板能回答的只有程度问题:点击率 1.2% 还是 2.4%、单次询盘成本 $8 还是 $15。它回答不了原因:买家是被价格劝退,被图片误导,还是被认证疑虑拦住。答案全在反馈里:
| 反馈渠道 | 能回答什么 | 数据面板回答不了的 |
|---|---|---|
| 帖子评论区 | 文案哪句话触发兴趣、哪些人群在围观 | 「为什么这一版素材点击高」——评论区原话会告诉你 |
| Messenger 私信 | 买家的真实采购阶段和顾虑排序 | 「询盘多但质量差」差在哪个环节 |
| 落地页行为 | 页面哪里断裂:价格区?认证区?表单? | 「点击进来为什么不出询盘」 |
三处反馈合成一张图,就是这轮测试的完整诊断书。只看面板做决策的企业,等于只拿体温计看病——知道发烧,不知道病因。
二、五类反馈,五种处理方式
反馈整理的核心动作是分类。五类反馈的处理路径完全不同,混在一个池子里就都处理不好:
| 反馈类型 | 典型原话 | 说明什么 | 处理方式 |
|---|---|---|---|
| 价格质疑 | "too expensive" / "any discount?" | 报价结构或价值表达有缺口 | 升级到定价层,不是改素材 |
| 参数追问 | "what's the MOQ?" / "220V ok?" | 素材参数给得不够 | 把被追问的参数写进下一版素材 |
| 认证合规 | "CE certified?" / "FDA list?" | 目标市场合规是决策关键项 | 认证信息前置到素材或落地页首屏 |
| 交期物流 | "lead time?" / "shipping cost?" | 买家进入评估后期,是好信号 | 快速答复 + 引导要规格单 |
| 无关噪声 | 表情、闲聊、同行试探 | 无采购意图 | 归档不处理,但留档防误判 |
分类之后的频次统计是真正值钱的产出:「认证追问」在 30 条反馈里出现 12 次,意味着你的素材里认证信息的位置或清晰度有问题——这是可以直接执行的修改指令,比「点击率低了」具体一百倍。
频次统计要立得住,反馈表本身的字段就得先标准化。一张能跨轮次积累的反馈表,至少带齐这几列:
| 字段 | 示例 | 为什么必须有 |
|---|---|---|
| 反馈原文 | "Is this CE certified for EU market?" | 原话是频次统计的原料,转述会失真 |
| 渠道 | Messenger 私信 | 分类与权重按渠道校准 |
| 素材编号 | AD-1104-03 | 归因的锚点,用编号不用描述 |
| 类型 | 认证合规 | 五类之一,自动打标 + 人复核 |
| 处理状态 | 已升级为素材修改 | 整改看这个字段:改了没、验证没 |
字段不标准的反馈整理,第二轮就会垮——第一轮还能靠热情翻记录,第二轮发现上一轮的记录对不上这一轮的口径,就没人再坚持了。先把表立对,再谈坚持。
三、归因:每条反馈挂回素材,结论才能积累
整理反馈最容易犯的错是不做归因:把所有反馈记成流水账,三个月后没法回答「这条素材该不该续投」。归因规则很简单:
| 归因层级 | 记什么 | 用途 |
|---|---|---|
| 素材级 | 反馈挂在哪条广告素材下(用素材编号,不用截图日期) | 判断单条素材的去留 |
| 文案层级 | 反馈指向素材里的哪句话、哪个画面元素 | 指导下一版文案怎么改 |
| 品类级 | 同类反馈跨素材重复出现的模式 | 上升为报价结构、页面结构的产品级修改 |
三个层级合起来,广告测试才真正在「积累经验」:素材级结论告诉你这一轮谁赢,品类级结论告诉你下一轮怎么一开始就赢。我们的经验是:跑过 3 轮以上有归因测试的企业,后续素材的一次通过率明显更高——因为常踩的坑都已经写在上一轮的反馈表里。
四、WorkBuddy 的分工:机器整理,人下判断
| 环节 | WorkBuddy 做 | 人做 |
|---|---|---|
| 收集 | 三处反馈自动汇入一张表,去重、挂素材编号 | 确认归因是否正确 |
| 分类 | 五类自动打标,频次自动统计 | 复核边界样本(如「同行试探」伪装成参数追问) |
| 产出 | 每轮测试出一页反馈摘要:Top 顾虑、参数缺口、认证追问占比 | 决定下一版素材改什么、报价结构动不动 |
| 沉淀 | 历史轮次的反馈库可检索 | 把高频问题升级成 FAQ 或素材常备要素 |
红线照旧:WorkBuddy 不代发回复、不自动改广告。反馈整理是给决策供料,决策在人——测试烧的是你的预算,判断权不能外包。
五、三个错误做法
错一:「点击率好就是好素材,反馈不重要」
高点击低询盘的素材比比皆是:夸张图骗来的点击,反馈区全是「price?」加关页。判断素材好坏的唯一标准是有效询盘成本,反馈正是解释这个数字的钥匙。只看点击率选素材,会系统性偏向标题党——点击越选越贵,询盘越选越少。
错二:「负面反馈就当没看见」
"too expensive" 不是噪声,是市场在告诉你价值表达或定价结构有缺口。把负面反馈删掉、不归档,等于把最贵的市场调研扔进垃圾桶。正确做法:负面反馈单独标色,攒够 10 条做一次专项复盘——价格类负面集中在某个市场,可能说明该市场该换报价档位,而不是换素材。
错三:「测试一轮就下结论」
样本量不够的结论都是噪声:一条素材跑一天收到 3 条反馈,看不出任何模式。最低门槛是 2 轮、每轮反馈 ≥20 条,模式重复才算信号。着急下结论的代价是错杀好素材或续投差素材——两种错的成本都比多等一轮高。
六、大宗师的判断:反馈库是中小外贸企业最便宜的市场调研
三条判断,带推理。
第一,广告反馈是被付费验证过的真实需求,比任何报告都贴近你的市场。 咨询报告讲的是行业平均,广告反馈讲的是「看到你产品的人此刻在想什么」——而且这些人是从投放定向里筛出来的准买家。一个月的广告测试攒下的 100 条反馈,信息密度抵得上一份几万块的市场报告。不整理反馈的企业,是花了广告费只买了点击,把调研报告的部分退货了。
第二,反馈整理是国内 AI 时代的内容原料。 高频问题就是买家会问 AI 的问题:反馈库里「CE certified?」出现 20 次,意味着 AI 那边也会有很多人问同样的认证问题——把答案写成落地页和帖子的确定句,就是在提前布局 AI 引用。我们的双周监测(当事方自述口径)反复看到:被 AI 稳定引用的内容,主题都来自「真实被反复问的问题」。反馈库就是这个问题清单的免费版。
第三,反馈处理速度是团队执行力的照妖镜。 同样 30 条反馈,有人当周出修改清单,有人三个月还在「素材再测测」。广告测试的差距不在预算,在反馈到修改的周转速度——而这个速度取决于反馈有没有被结构化。散落的反馈永远「有空再看」,结构化的反馈每周自动排在待办里。
七、反转条件
- 广告还在冷启动,反馈不到 20 条——先攒样本,别急着分类下结论;
- 反馈以同行和供应商为主——先收紧投放定向(地区、职位、兴趣),把噪声源切掉再整理;
- 单价极低、纯零售复购品类——反馈整理的颗粒度可以放粗,重点只盯价格与物流两类;
- messenger 私信量远大于评论——整理重心移到私信侧,评论区降级为次渠道;
- 广告结构大改(换市场、换品类)——历史反馈库按品类分档归档,新旧不混。
八、正确的顺序
- 先建表:反馈表配好五类字段和素材编号列,历史反馈回填一周的量;
- 再归因:确认每条反馈挂对了素材,挂不上的单独放「待归因」别硬塞;
- 跑两轮:两轮测试后做第一次频次复盘,出 Top 3 顾虑;
- 改一轮:按 Top 3 改素材或页面,验证反馈是否减少——反馈减少才证明归因对了;
- 月度沉淀:高频问题升级成 FAQ、素材常备要素、报价结构调整三选一。
常见问题
多少条反馈开始整理才有意义?
20 条是起步线,50 条能出第一版可靠的频次统计。低于 20 条的分类结果随机性太大,会把噪声当模式。注意是「有效反馈」20 条——干扰类留言不计入。
反馈整理要多少人力?
结构化之后每周约 1–2 小时:复核自动分类的边界样本、看一页摘要。没有结构化时,多数企业不是不想整理,是每次都要从 Messenger 翻记录、从评论区截图,单次就要半天,坚持不下来。工具的价值是把「半天」压成「1 小时」,坚持才有可能。
反馈结论和数据面板结论打架怎么办?
信反馈,查数据。典型冲突:面板显示 CTR 很高,反馈却全是「看不懂这是卖什么的」——先怀疑统计口径(点击里有没有误触和同行)和归因(高 CTR 是不是同一批人反复点)。反馈是原始信号,数据是加工信号,原始信号更接近真相。
历史广告的反馈还要补录吗?
只补主力素材的:现在还在投放、或月花费进过前 10 的素材,回填它们的反馈(评论区还能翻到,私信看归档)。已经下线的小素材不补——沉没成本,整理它的时间不如用来跑新一轮。
这套整理方法能用到其他平台吗?
框架完全通用(分类五类、归因三层、两轮起判),LinkedIn 的评论、WhatsApp 的询盘都能套。差别只在渠道字段和分类权重:LinkedIn 反馈里「身份类」信息多(买家自报职位),权重调高;WhatsApp 里「交期物流」占比通常更高。一套框架多平台复用,反馈库越攒越厚。
想聊你自己的具体业务场景,联系大宗师网络(外贸社媒训练营):微信 Dazongshi98。
本篇常见问题
多少条反馈开始整理才有意义?
20条是起步线,50条能出第一版可靠的频次统计。低于20条的分类结果随机性太大,会把噪声当模式。注意是「有效反馈」20条——干扰类留言不计入。
反馈整理要多少人力?
结构化之后每周约1–2小时:复核自动分类的边界样本、看一页摘要。没有结构化时,多数企业不是不想整理,是每次都要从Messenger翻记录、从评论区截图,单次就要半天,坚持不下来。
反馈结论和数据面板结论打架怎么办?
信反馈,查数据。典型冲突:面板显示CTR很高,反馈却全是「看不懂这是卖什么的」——先怀疑统计口径(点击里有没有误触和同行)和归因(高CTR是不是同一批人反复点)。
历史广告的反馈还要补录吗?
只补主力素材的:现在还在投放、或月花费进过前10的素材,回填它们的反馈(评论区还能翻到,私信看归档)。已经下线的小素材不补——沉没成本,整理它的时间不如用来跑新一轮。
这套整理方法能用到其他平台吗?
框架完全通用(分类五类、归因三层、两轮起判),LinkedIn的评论、WhatsApp的询盘都能套。差别只在渠道字段和分类权重:LinkedIn反馈里「身份类」信息多(买家自报职位),权重调高;