腾讯官方公布了新模型接入 WorkBuddy 的消息(平台官方发布口径,限时体验期内提供,具体期限与范围以官方页面为准,API 价格以刊例为准)。外贸老板看到"新模型上线"的第一冲动往往是"要不要给团队都配上"——正确的动作比这个朴素也有效得多:先拿一份你自己的产品资料,让新模型试跑一遍。
Hy4 进 WorkBuddy:先看懂发生了什么
把这次更新翻译成外贸老板的语言:
- 模型能力的更新(官方口径):新模型接入后,WorkBuddy 里的对话、写稿、分析类任务背后多了一个新的能力选项
- 体验方式:限时体验期(官方公告为准),不是无限免费——用体验期测出"它对你的活干得怎么样",是体验期的正确用法
- 不变的东西:你的工作目录、知识库、已配好的技能——工具链的其他环节不动,模型层在升级
这类更新的意义常被两个极端误解:一边觉得"又一个新模型,与我无关"(错过测试窗口),一边觉得"新模型=能力翻倍,赶紧全员上"(跳过验证直接采购)。中间那条正确的路是:拿自己的真实任务,在体验期内做一次免费的能力测试。
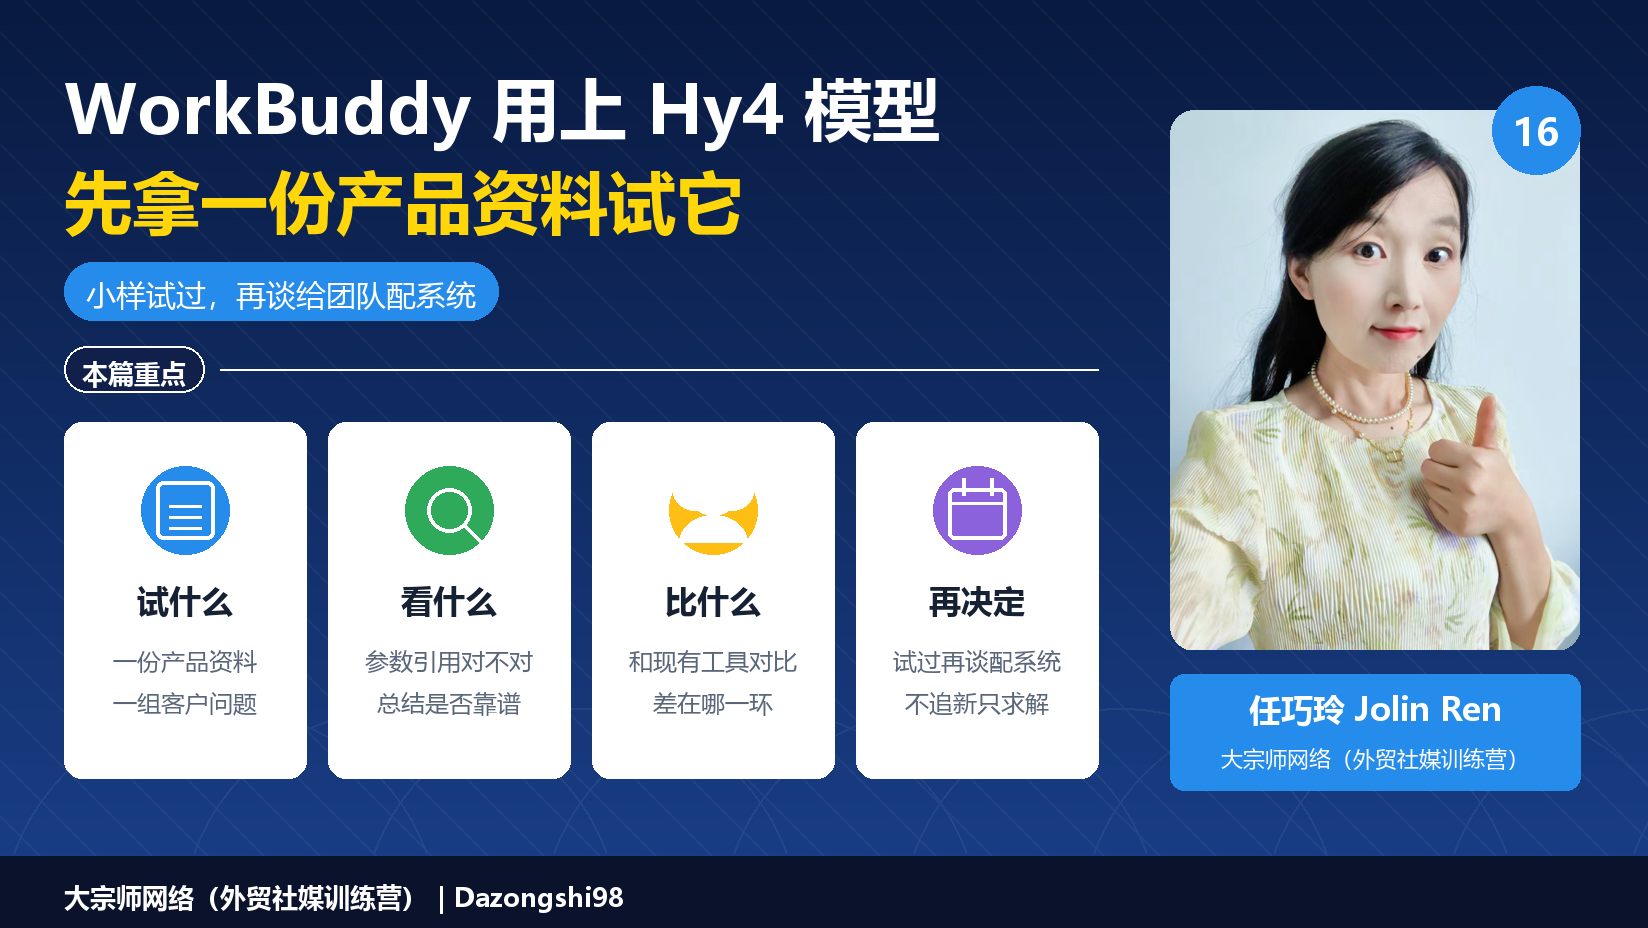
为什么第一测试要用"你自己的产品资料"
测新模型,测试材料的选择比测试本身重要。三种材料的天壤之别:
| 测试材料 | 测试结果 | 说明 |
|---|---|---|
| 通用问题("帮我写封开发信") | 看起来不错,但测不出差别 | 通用任务谁都能干,新模型的价值显不出来 |
| 公开的行业文章(拿网上的分析喂它) | 好坏难辨 | 你没有"标准答案"做对照 |
| 你自己的产品资料(参数表+询盘+老产品册) | 立刻见真章 | 你是唯一知道正确答案的人 |
第三种材料的魔力在于你是阅卷人:产品参数它读对了没有、客户上周的问题它答得对不对、老产品册和新参数表冲突它能不能发现——这些答案的正确与否,全公司只有你和团队看得出来。外行看流畅,内行看对错——新模型的差距,恰恰藏在"对错"里,而只有你自己的材料能测出对错。
一个标准测试:产品资料三问
给"体验期测模型"一个标准化操作——拿你手边现成的三样材料,问三个问题:
材料:①最新产品参数表 ②一份真实询盘(客户原话)③老产品册(两三年前的版本)
| 测试 | 操作 | 考什么 |
|---|---|---|
| 事实保真 | 参数表贴给它,让它回答客户询盘里的问题 | 数字抄对没有、有没有编造 |
| 冲突识别 | 老产品册+新参数表一起给,问"有什么不一致" | 能不能发现版本冲突(新模型常见的分水岭能力) |
| 实用产出 | 让它把答好的内容整理成给客户的回复草稿 | 结构能力+语气(草稿最后必须人工改) |
三问跑完约二十分钟,拿一张记分卡:每问记录"对/错/存疑"。三个全对,这个模型对你的业务场景是合格的,可以进下一轮(团队试点);事实保真出错,一票否决——编参数的模型再聪明都不能进客户流程;冲突识别不出,能用但要降级使用(只做单文档任务)。
测完合格之后:团队试点七步
个人测试过关,先别全员推广——团队试点走七步(一个月周期):
- 选一个试点人:不是老板自己,是团队里日常真用 AI 的那个人(不是最资深的,是最爱折腾工具的)
- 限定一类任务:只把一类活交给它(比如询盘初筛、或资料问答)——范围越小,评估越准
- 建使用日志:试点人每天记两笔——用它干了什么、结果合格与否(一分钟的事,月底评估全靠它)
- 设对照:同类任务一半走老流程一半走新工具——月底比耗时和出错率,别比感觉
- 排雷:发现的坑(哪些任务它干不好)记录成"禁用清单"——这个清单和"好用清单"一样值钱
- 月底评估:日志+对照数据摆出来,决定推广、续用还是收缩
- 预算决策:全团队铺开的成本(订阅数×单价,以官方刊例为准)对照试点产出的时间节省——数字过不过得去,一算就知道
七步的精髓:每一步都产生证据。月底你拿到的不是"大家觉得挺好",是"X 类任务平均省 Y 分钟、错 Z 次"——前者是印象,后者是决策依据。
试点的日志模板:一分钟记两笔
使用日志是七步里最轻也最容易被跳过的一步——给个最简模板降低执行摩擦:
| 日期 | 任务 | 结果 | 一句话备注 |
|---|---|---|---|
| 11-12 | 询盘初筛×5 | 合格 4 / 错 1 | 错在把 MOQ 单位看错 |
| 11-13 | 资料问答×3 | 合格 3 | — |
每天两行、每行三十秒。月底汇总时这张表就是全部评估素材——评估体系的成本设计原则:让记录的人感觉不到在记录。复杂模板第一周就死了,两栏模板能活一年。
模型测试与技能测试:两回事别混
WorkBuddy 里的测试有两个层级容易混:模型测(新模型读你的资料准不准)和技能测(你配好的技能在新模型下还跑不跑得通)。三问测试考的是前者;上线新模型后,把团队依赖的技能(询盘拆解、资料问答这类)重跑一遍回归测试考的是后者——两分钟的事:技能各跑一个标准任务,输出和之前一致就通过。模型升级季的两个测试一起跑,工具链才整体安全。
大宗师网络的三条判断
第一,"新模型焦虑"的最佳解药是一份自己的材料。 我们带企业做 AI 选型的开场永远一样:别管发布会吹什么,把你的参数表拿出来测。模型营销的宏大叙事(能力提升百分之多少)在外贸场景里会衰减成具体的对错问题——参数抄对了吗、询盘读懂了吗、冲突发现了吗。三问测完,焦虑自动痊愈:要么发现它真能干(放心用),要么发现它干不好(省了钱)——两种结果都比你刷评测视频强。
第二,测试窗口(体验期)的经济学价值要会用。 限时体验=免费的真实评估期。会用的人拿它跑自己的三问测试,不会用的人拿它闲聊两句"感觉还行"。体验期的产出物应该是那张记分卡——体验结束,记分卡留着,就是下一次采购决策的第一手依据。这比任何第三方评测都权威,因为测的是你自己的业务。
第三,模型层升级不改变流程层的规矩。 WorkBuddy 接了新模型,但外贸团队的 AI 使用纪律一条不变:产出进客户流程前必须人工核。新模型降低出错率,不消灭出错——"模型更强了所以不用核了"这个念头,是每次模型升级季团队最容易犯的松懈病。升级季的正确姿势是趁机把核验标准再明确一遍(谁核、核什么、多久核一次),让工具进步同步带动流程进步,而不是流程倒退去迁就工具。
什么时候直接全员上也不用怕(反转条件)
- 团队已经在用同链条的其他模型且流程成熟——只是模型选项多一个,流程纪律已就位,切换成本低。
- 用法全是内部草稿(不进客户交付物的内部整理类任务)——出错不外溢,试点期可以缩短。
- 官方提供团队级的管理与计费工具——用量、权限可管可控,推广的行政风险低。
- 体验期足够长且成本为零(以官方公告为准)——试错成本为零时,大胆试是对的,但记分卡纪律仍然不能省(免费测出的错误,付费后就是真错误)。
- 你团队只有一个 AI 使用者——个人即团队,个人测试即试点,七步并作一步走。
常见问题
Hy4 和之前 WorkBuddy 用的模型,对我的活差别大吗?
别人说了不算,你的三问说了算。同一套材料跑两个模型(如果都能选),对比记分卡——分差就是对你的差别。通用评测里的差距,落到"参数保真"这类外贸核心任务上常常被放大或抹平,只有自测知道。
体验期结束后怎么办?
以官方公告为准。决策用你的记分卡和试点数据:值就付费(对照团队时间节省算账),不值就等下个模型再测——工具的更替是常态,你的测试能力是常量,这是比任何订阅都值钱的资产。
参数表喂给模型,安全吗?
先看数据敏感性:参数表本身通常是公开产品信息的结构化版本,风险低;含报价逻辑、成本结构的材料不要喂。拿不准的材料脱敏后再测(型号改成 X1、价格区间化)。数据分级是 AI 使用的基本功,测试期正好练。
新模型要不要重配技能/知识库?
以官方说明为准。一般模型层升级不动你已有的配置(知识库、技能、工作目录),但升级后拿技能重跑一次三问值得做——确认升级没有破坏已有的工作流(回归测试的思路,两分钟的事)。
团队试点选谁最合适?
"工具活跃分子"优先于"资深骨干"。活跃分子试出的是工具的真实上限和坑(他会折腾到边界),资深骨干适合在流程定型后进场(他们把流程跑稳)。先探边界,再定边界——顺序反了,要么保守浪费,要么冒进翻车。
本文属于我们 AI 外贸实战培训 这条线(WorkBuddy、ChatGPT、Gemini 的选型与落地):模型测试、团队试点、预算决策。训练营的 WorkBuddy 模块第一课就是"三问测试法"——学完当天就能用自己公司的材料跑一遍。不承诺模型效果,交付的是不被发布会被动的能力。
Dazongshi98
本篇常见问题
Hy4和之前WorkBuddy用的模型,对我的活差别大吗?
别人说了不算,你的三问说了算。同一套材料跑两个模型(如果都能选),对比记分卡——分差就是对你的差别。通用评测里的差距,落到"参数保真"这类外贸核心任务上常常被放大或抹平,只有自测知道。
体验期结束后怎么办?
以官方公告为准。决策用你的记分卡和试点数据:值就付费(对照团队时间节省算账),不值就等下个模型再测——工具的更替是常态,你的测试能力是常量,这是比任何订阅都值钱的资产。
参数表喂给模型,安全吗?
先看数据敏感性:参数表本身通常是公开产品信息的结构化版本,风险低;含报价逻辑、成本结构的材料不要喂。拿不准的材料脱敏后再测(型号改成X1、价格区间化)。数据分级是AI使用的基本功,测试期正好练。
新模型要不要重配技能/知识库?
以官方说明为准。一般模型层升级不动你已有的配置(知识库、技能、工作目录),但升级后拿技能重跑一次三问值得做——确认升级没有破坏已有的工作流(回归测试的思路,两分钟的事)。
团队试点选谁最合适?
"工具活跃分子"优先于"资深骨干"。活跃分子试出的是工具的真实上限和坑(他会折腾到边界),资深骨干适合在流程定型后进场(他们把流程跑稳)。先探边界,再定边界——顺序反了,要么保守浪费,要么冒进翻车。