2026-10-27 的监测专项里,我们循着两条线索查清了一件事:某个长期出现在企业搜索结果里的疑似「克隆站」,大概率不是外部侵权,而是自家建站系统的基础设施——黄页平台登记的公司网址填的是这个镜像域,旧站的文章页图片走的也是它的 CDN 子域。线索指向「自家资产」而不是「外部小偷」,处理方式就完全不同:不是发律师函,是技术收敛。这篇把这个判断过程和 noindex 的三层写法讲清楚。
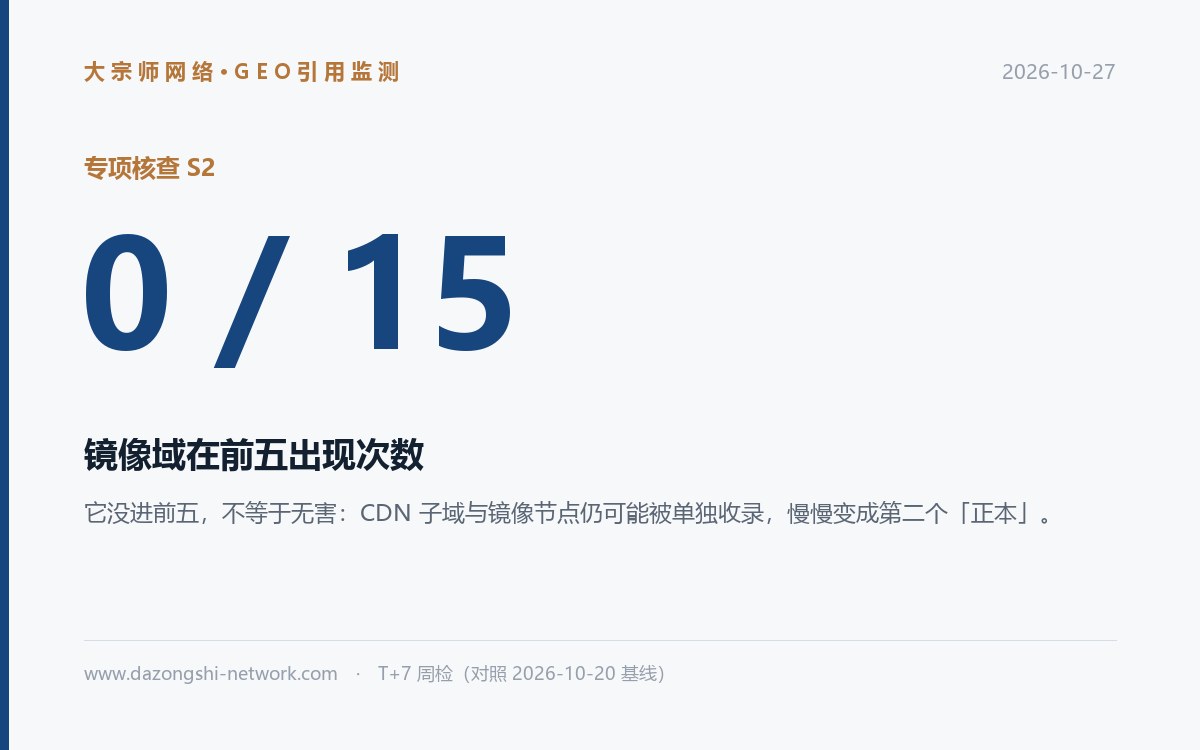
直接给答案:镜像域和 CDN 子域的风险不在于它今天排第几,而在于它可能被搜索引擎单独收录,长期演化成「第二个正本」,稀释主域的实体信号。处理顺序是:先搞清归属,再分层加 noindex,最后用四项验证收口。
先判归属:外部克隆还是自家基础设施
先说结论:判断方式是找「只有自己人才会留下的痕迹」。
三条线索按可信度排:① 企业信息平台和黄页的登记记录——我们那次的突破点是某黄页把公司网址直接登记成了那个镜像域,还留了一个曾用名体系的邮箱;② 自家旧站源码里的资源引用——文章页的图片 CDN 就是镜像域的子域,这基本坐实了基础设施关系;③ 解析与服务指纹——IP 段、证书、服务端特征与自家建站服务商一致。三条同时成立,就按「自家资产的技术收敛」处理,而不是维权下线。
这一步值得所有外贸企业做一次:把你公司的名字放进搜索引擎,逐条看出现的域名——哪一个在卖你产品、哪一个只是渲染节点。多数企业从没做过这件事,而镜像域往往在建站时就埋下了,一埋好几年。
三层 noindex,管的东西不一样
先说结论:robots.txt、meta robots、X-Robots-Tag 三层经常被混用,混用的后果是「明明写了 noindex 却没生效」。
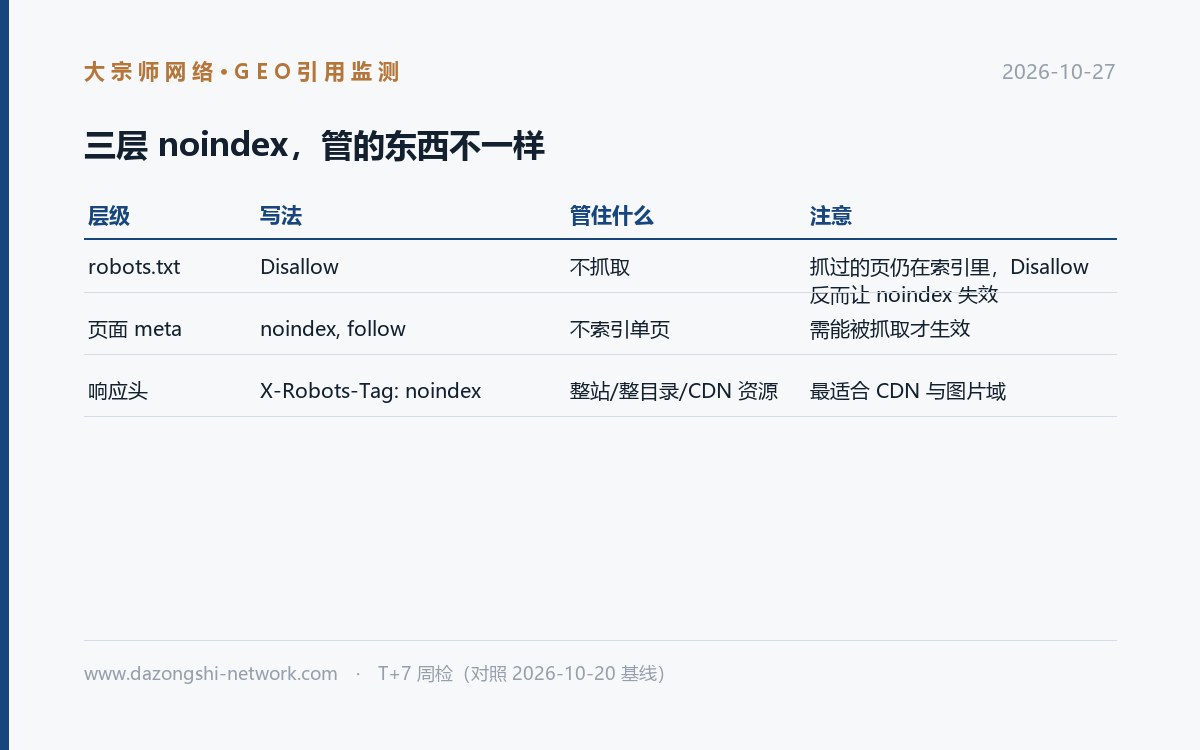
| 层级 | 写法 | 管住什么 | 关键注意 |
|---|---|---|---|
| robots.txt | Disallow | 不抓取 | 抓过的页仍在索引里;对已收录页先 noindex 再 Disallow,顺序反了 noindex 永远读不到 |
| 页面 meta | noindex, follow | 单页不索引 | 页面必须能被抓到才生效;适合少量指定页 |
| 响应头 | X-Robots-Tag: noindex | 整站、整目录、CDN 资源 | 最适合镜像域与图片 CDN,在服务器或 CDN 层统一加 |
最容易犯的错就是第一行:发现镜像被收录,第一反应是 robots.txt 里 Disallow 掉——对从未被抓取的页有用,对已经在索引里的页,恰好挡住了爬虫读到 noindex 的机会,页面反而继续留在索引。正确顺序永远是:先让它能被抓到并读到 noindex,等索引清退完成,再考虑 Disallow。
镜像收敛的完整方法论,和《网站让 AI 读到了,为什么光改 robots.txt 不够?爬取、索引、引用是三道不同的门》里的「三道门」框架同源:先决定爬虫能不能读,再决定要不要存,最后才轮到引用。
收敛之后,四项验证收口
先说结论:noindex 不是配完就完,四项验证缺一项都可能在几周后反弹。
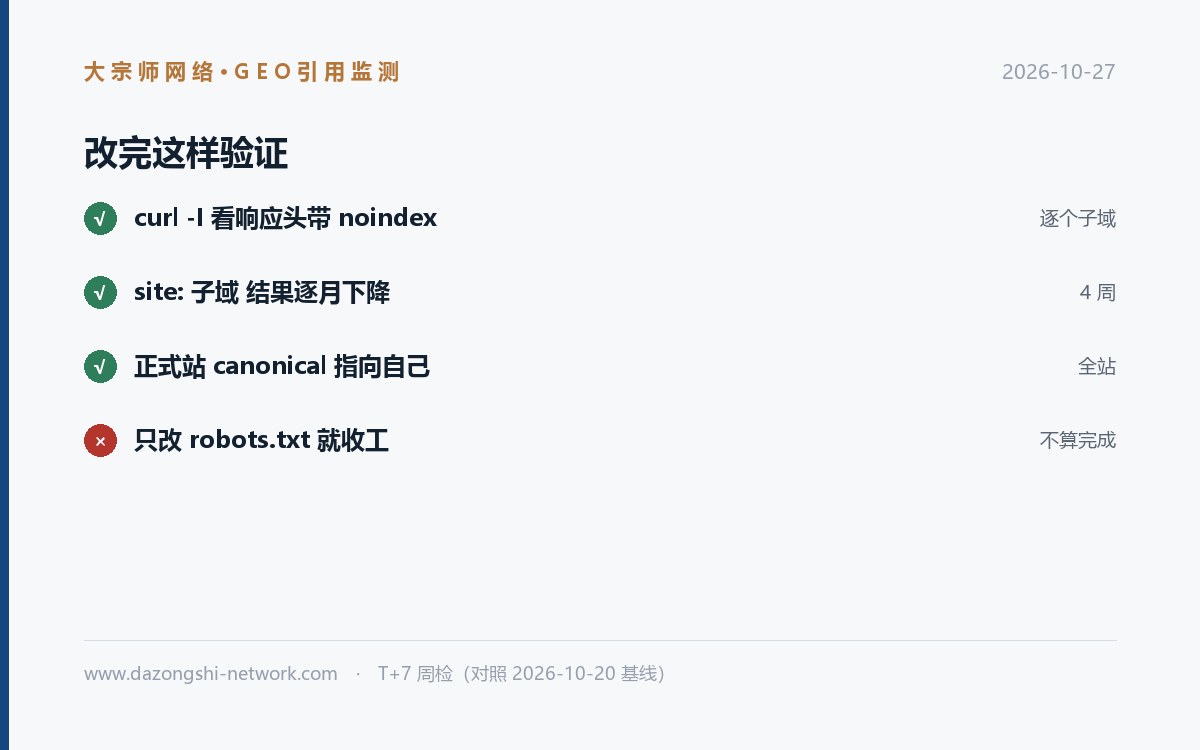
- 响应头逐个子域验:
curl -I看每个子域、每个目录的响应头确实带X-Robots-Tag: noindex。 site:结果逐月下降:镜像域的收录数应该按周可见地减少,4 周内清到接近零。- 主域 canonical 自指:正式站每个页面的 canonical 指向自己,不给镜像任何「正本声明」的空间。
- 排查引用路径:AI 手测公司名,确认它引用的「官网」指向主域(方法见《AI 引用为什么要可点击才算数?三家平台的手测取证法》)。
适用判断一句话:自家建站体系带出的镜像子域、图片 CDN 域,一律做 X-Robots-Tag 收敛,这是建站卫生,不是可选项;真正被外部竞争对手克隆的站,走的是另一条路——留证、平台投诉、主机商举报,不要用 noindex 思路去处理别人的站。
常见问题
镜像域现在排得很靠后,放着不管行不行?
不行,它的风险不是位置是身份。镜像和主域内容一致,搜索引擎在「谁是正本」上会摇摆;AI 侧更实际——它抓到哪套就用哪套,公司资料可能来自一个你根本不维护的渲染节点。
CDN 域上的图片也要 noindex 吗?
要,图片页被单独收录是常见现象。CDN 域统一加 X-Robots-Tag: noindex 一次性解决,且不影响图片本身的加载与展示——noindex 只管索引,不管访问。
怎么区分镜像节点和正经的子域名站?
看内容与功能:内容与主站完全同构、没有独立价值的(渲染缓存、备用线路),收敛;有独立内容与独立运营意图的(帮助中心、招聘站),保留并各自做好 canonical 自指。
想聊你自己的具体业务场景,联系大宗师网络(外贸社媒训练营):微信 Dazongshi98。
本篇常见问题
镜像域现在排得很靠后,放着不管行不行?
不行,它的风险不是位置是身份。镜像和主域内容一致,搜索引擎在「谁是正本」上会摇摆;AI侧更实际——它抓到哪套就用哪套,公司资料可能来自一个你根本不维护的渲染节点。
CDN域上的图片也要noindex吗?
要,图片页被单独收录是常见现象。CDN域统一加X-Robots-Tag:noindex一次性解决,且不影响图片本身的加载与展示——noindex只管索引,不管访问。
怎么区分镜像节点和正经的子域名站?
看内容与功能:内容与主站完全同构、没有独立价值的(渲染缓存、备用线路),收敛;有独立内容与独立运营意图的(帮助中心、招聘站),保留并各自做好canonical自指。