robots.txt 里明明写了允许 GPTBot、PerplexityBot、OAI-SearchBot 进来,翻了一个月的服务器日志,这些爬虫的抓取次数却是零。这个症状在 2026 年的技术审计里被点名为头号隐患:问题多半不在 robots.txt,而在你前面那层 CDN 或 WAF——它对 AI 爬虫直接返回 403,你的网站根本没机会「说话」。本文给出确诊三步和白名单做法,外贸独立站按表自查。
一条完整的抓取链路:三层各管一段,断哪层症状不同
先把链路摆正,才知道该查哪一层。AI 爬虫从出发到你的内容被引用,中间至少经过三层:
| 层 | 谁在管 | 管什么 | 断了的表现 |
|---|---|---|---|
| 权限层 | robots.txt | 声明「允许/禁止谁进来」 | 爬虫遵纪守法,看到 Disallow 就不来 |
| 边缘层 | CDN / WAF / 防火墙 | 真正执行「谁来直接挡回去」 | 爬虫来了,但在门口收到 403 或验证挑战 |
| 内容层 | 页面本身 | HTML 是否可解析、内容是否可提取 | 爬虫进了门,读完提不出东西(见 Claude 和 Perplexity 不执行 JavaScript?用建站模板的外贸站要当心) |
关键认知:robots.txt 是意向声明,不是执行层。你在权限层写了「欢迎光临」,边缘层的保安照样可以把客人拒之门外——而且保安不会告诉你,客人也不会投诉,你只能从日志里发现「说好的来访一次都没发生」。
这就是为什么「光改 robots.txt 不够」的排查要往深处走:三层里任何一层断了,最终症状都是 AI 不引用你,但修法完全不同。
「放行了但零抓取」的第一嫌疑:CDN 边缘的隐形 403
2026 年 11 月上旬的行业技术审计把这个问题摆到了台面上:大量网站在 robots.txt 里正确放行了 AI 搜索爬虫,日志里的抓取次数却为零,审计归因大部分指向 Cloudflare Bot Fight Mode 或类似安全插件的默认防御策略——在边缘层直接对 PerplexityBot、GPTBot 等返回 403 Forbidden,或者弹出人机验证挑战。
爬虫不会去填验证码,它收到 403 就走,而且大概率短期不再优先回来。对 AI 搜索引擎来说,你的站等于「不可达」——不是内容不好,是门没开。
这个坑之所以叫「隐形」,是因为它骗过了三层人:
| 谁被骗 | 为什么看不出来 |
|---|---|
| 老板 | 网站访问正常,前台页面打得开,谁会想到爬虫被挡 |
| 建站服务商 | 只负责页面渲染,CDN 规则是开通时一键默认的 |
| robots.txt 检查工具 | 工具只读文件内容,不会真的模拟爬虫去敲门 |
判断是否踩坑只有一个硬标准:日志里有没有这些 UA 的抓取记录,以及返回状态码是什么。想知道怎么导日志,先看 AI 爬虫来过你网站吗?外贸企业查日志的三个动作。
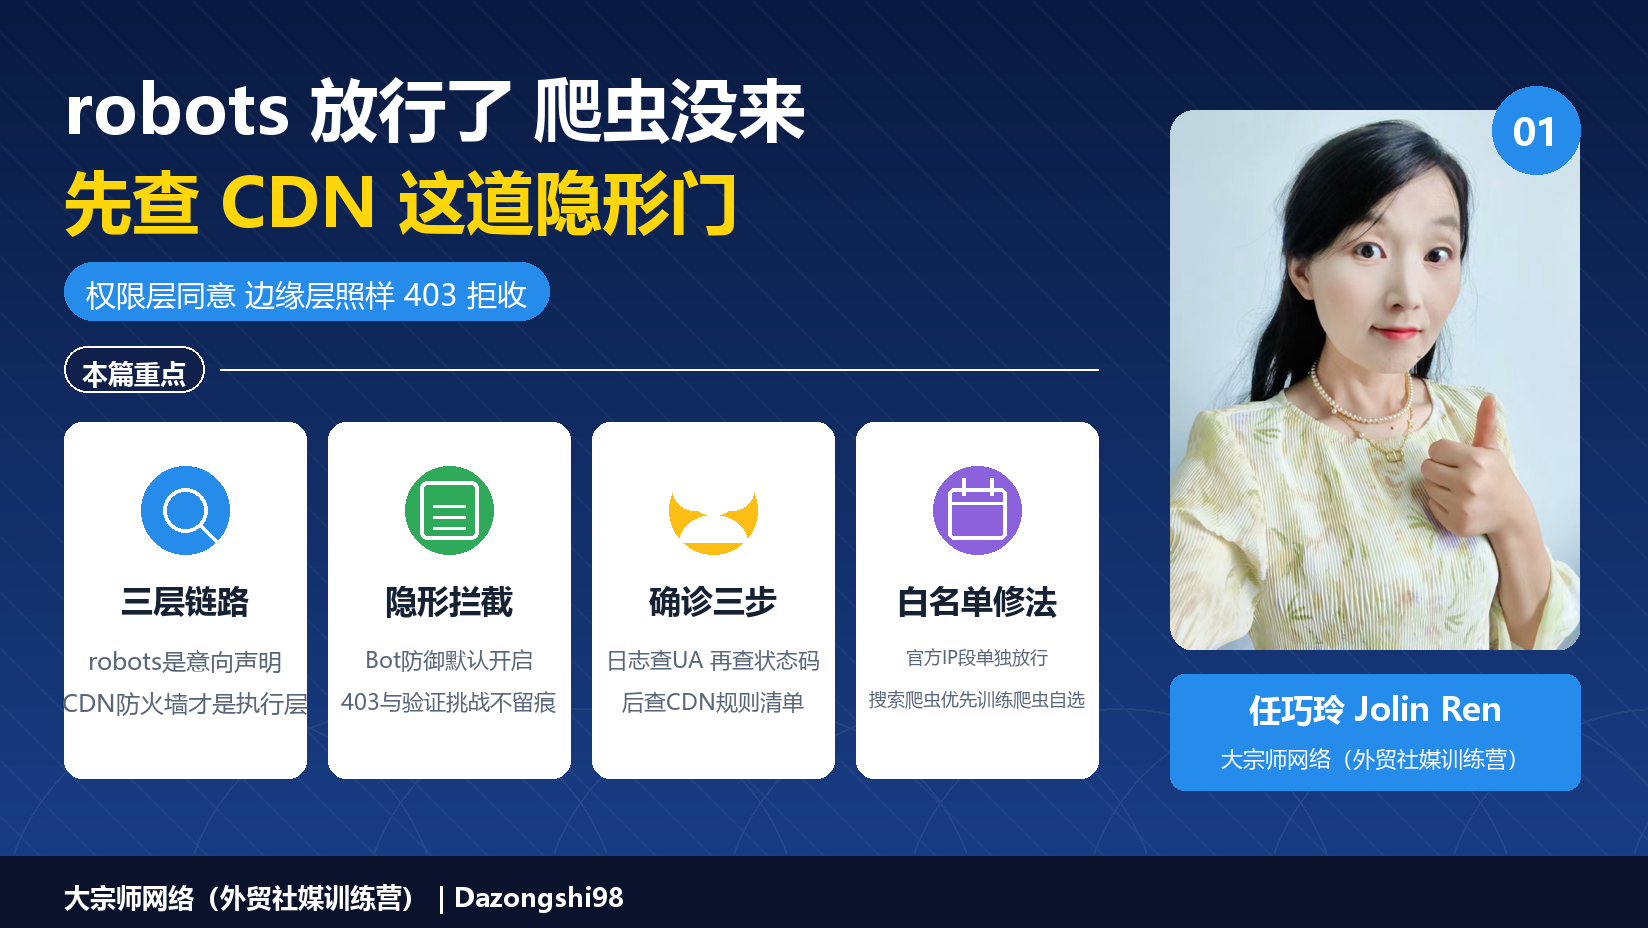
确诊三步:从「感觉没人来」到「知道门断在哪」
不要凭感觉下结论。按顺序做三步,每一步都有明确的证据物:
| 步骤 | 动作 | 证据物 | 结论分支 |
|---|---|---|---|
| 第一步:查日志 | 导出近 30 天访问日志,按 UA 过滤 GPTBot / OAI-SearchBot / PerplexityBot / ClaudeBot | 抓取次数清单 | 有抓取 → 去查内容层;零抓取 → 进第二步 |
| 第二步:查状态码 | 如果日志里有记录,看返回码是 200 还是 403 / 503 | 状态码分布 | 403 占多数 → 边缘层拦截实锤,进第三步 |
| 第三步:查 CDN 后台 | 登录 Cloudflare(或你家 CDN)的安全 / 防火墙规则页 | 拦截规则清单 | 找到 Bot Fight Mode 或类似开关和命中数 |
三步走完,你手里有的不是「我的网站好像不被 AI 喜欢」这种模糊焦虑,而是「PerplexityBot 上月尝试 217 次、209 次收到 403、拦截规则是 CDN 后台某某开关」这样可以直接交给技术改的事实。
一个重要提醒:确诊之前,别拿搜索引擎的 site: 查询当判据。我们自己 2026 年 11 月做过一轮收录诊断:用 site: 查自家站返回零结果,一度以为 Google 完全不抓取;后来到 Google Search Console 官方后台核对,抓取与收录数据一切正常——site: 查询在反爬机制下会误报,只有官方后台的数字能作数。这个教训写在这里:判断「AI 或搜索引擎有没有来」,永远以服务器日志和官方后台为准,不要以搜索框查询结果为准(展开见 拿搜索引擎结果当 AI 引用率?这个代理指标能用到哪一步)。
白名单怎么做:官方 IP 段加规则放行
确诊是边缘层拦截后,修法业界已经收敛成标准动作——按爬虫官方公布的 IP 段,在 CDN 后台单独建白名单规则:
| 动作 | 说明 | 注意点 |
|---|---|---|
| 取官方 IP 段 | OpenAI、Anthropic、Perplexity 均在官方文档公布爬虫 IP 段 | 定期复查,IP 段会扩容 |
| 建放行规则 | 在 CDN/WAF 后台建「来源 IP 在段内 → 允许」的规则,优先级高于防御策略 | 只放行官方段,不要全开 |
| 关闭误伤开关 | Bot Fight Mode 这类默认激进防御,评估后对合法爬虫豁免 | 不是关掉整个防护,是豁免白名单 |
| 修完复测 | 用官方提供的验证器或等日志出现 200 记录 | 以日志为准,不要以「感觉快了」为准 |
放行范围要克制:搜索爬虫(OAI-SearchBot、Claude-SearchBot、PerplexityBot)是决定你能否被 AI 搜索引用的,优先放行;训练爬虫(GPTBot、ClaudeBot、Google-Extended)可以按企业意愿单独决定——这两类的区别与配置方法,展开见 robots.txt 该怎么给 AI 爬虫配?外贸独立站先分清放行谁、挡住谁。
外贸站的特殊坑:模板建站,你根本没有 CDN 后台权限
这里外贸老板要先回答一个问题:你的站在谁手里?
| 建站方式 | CDN/WAF 控制权 | 发现 403 后怎么办 |
|---|---|---|
| 自购服务器 + 自配 Cloudflare | 自己 | 按上表自查自修,当天能改 |
| SaaS 建站平台 / 模板商托管 | 平台方 | 提工单,附日志证据,要求豁免主流 AI 爬虫 |
| 外包建站公司代维护 | 服务商 | 要后台只读权限或要求出截图,别只听口头「没问题」 |
| 国内机房无 CDN | 无边缘层 | 这个坑不存在,去查内容层和收录节奏(见 只交 sitemap 就等收录?新域名第一周基本等不来抓取) |
模板建站的外贸站尤其注意:平台自带的 CDN 你看不到也改不了,日志导出还要申请。这不是放弃的理由——正因为看不见,「向平台要一份爬虫抓取与状态码报告」应该成为每年固定动作,和查 Google Search Console 一样例行。
另外查边缘层时顺手看一眼自己的镜像域和 CDN 子域有没有变成「第二个正本」,那是另一个会稀释收录的坑(见 镜像域和 CDN 子域会不会变成第二个正本?noindex 该加在哪一层)。
三种「看起来像被 403」但其实不是的情况
排查时要防止把别的病也按这个方子治。三种容易误诊的情况:
- JavaScript 渲染问题:爬虫来了、页面也返回 200,但内容是脚本渲染的,AI 读到空壳——症状同为「不引用」,病在内容层,修法是把关键事实放进服务端返回的 HTML 里。
- 新站冷启动:上线两周零抓取是正常节奏,AI 搜索引擎对新域名的发现需要外部链接和提交动作配合,不是被谁挡了。
- 地理调度:部分 CDN 会按地区返回不同节点,日志分散在不同区域账户里,先确认你看的是全量日志再下「零抓取」的结论。
三种情况的共同解法还是那句话:回到日志和状态码,让证据说话。
修复后怎么验证:给 28 天观察窗口
白名单生效后,按固定节奏验收,不要天天盯:
| 时间点 | 看什么 | 期望 |
|---|---|---|
| 第 1 周末 | 日志新增抓取记录与状态码 | 白名单内爬虫出现 200 记录 |
| 第 2 周末 | 抓取量趋势 | 搜索类爬虫稳定回访(具体量级因站而异,看趋势不看绝对数) |
| 第 4 周末 | AI 搜索端的实际引用 | 在 ChatGPT / Perplexity 用固定问句手测,方法见 AI 引用为什么要可点击才算数?三家平台的手测取证法 |
28 天没起色再回炉诊断链,不要第一周没动静就推翻重来——AI 搜索引擎的索引更新有它自己的节奏。
什么企业不用急着做这轮排查
不是所有人都需要今晚就去翻日志:
- 网站上线不到两周——先等冷启动,别把正常节奏当故障。
- 日志里已有稳定的 AI 爬虫 200 记录——你的门是开的,该把精力放在内容层:前 200 字直答、可独立提取的段落、结构化标记这些 RAG 读取机制上。
- 主要客户来自展会和老客户复购、线上获词为零——AI 可见性暂时不是你的主要矛盾,先想清楚要不要开线上这条线。
- 已经在做系统性 GEO 交付——边缘层诊断本来就该是服务范围的一部分,让服务商出具证据而不是自己学。
常见问题
robots.txt 放行了,CDN 为什么还能拦?
因为两者管的事不同:robots.txt 是给爬虫看的意向声明,CDN/WAF 是在请求到达你服务器之前的执行层。爬虫先被边缘层挡回 403,根本走不到读 robots.txt 那一步——所以「改了 robots 没效果」不奇怪,要沿链路往下查。
怎么知道我的站前面有没有 CDN?
用响应头检测工具看 HTTP 响应头,出现 cloudflare、缓存代理类字段即有 CDN;模板建站的基本都有平台自带 CDN,直接问服务商「我家站是否经过你们 CDN、能否出爬虫日志」最快。
放行训练爬虫会不会有内容风险?
分两类看:搜索爬虫(OAI-SearchBot、Claude-SearchBot、PerplexityBot)决定你在 AI 搜索里能不能被引用,建议放行;训练爬虫(GPTBot、ClaudeBot、Google-Extended)涉及语料是否用于训练未来模型,属于企业自己的选择,关掉它不影响 AI 搜索引用。
没有服务器日志权限怎么办?
向建站平台或托管商提工单索要「近 30 天 AI 爬虫 UA 抓取次数与状态码」,这是合理的数据权利;拿不到日志的平台,至少要求确认「是否对主流 AI 爬虫返回 403」。两个都拒绝的平台,本身就是一个换供应商的信号。
403 修好后多久能在 ChatGPT 里看到引用?
以观察窗口口径:先看日志出现 200(1–2 周),再看引用(最多给到 4 周)。AI 搜索引擎的索引有更新节奏,引用滞后于抓取是正常现象;4 周日志正常但零引用,问题就转移到了内容层,按 RAG 读取机制的清单去查。
robots 放行、边缘拦截、内容提取,这三道门对应的是三种不同的修法——这也是我们 GEO 培训里诊断模块的标准动作:先拿日志和状态码定位断点,再对症处理,不凭感觉改网站。这篇文章本身的方法(三层链路、确诊三步、28 天验收窗口)就是我们交付给客户做自查的表。我们自己的站 11 月刚用同一套链路做过一轮收录诊断,site: 误报被官方后台数据实证推翻的完整过程,就是最好的教学案例。
想聊你自己的站到底断在哪一层,联系大宗师网络(外贸社媒训练营):微信 Dazongshi98。
本篇常见问题
robots.txt放行了,CDN为什么还能拦?
因为两者管的事不同:robots.txt是给爬虫看的意向声明,CDN/WAF是在请求到达你服务器之前的执行层。
怎么知道我的站前面有没有CDN?
用响应头检测工具看HTTP响应头,出现cloudflare、缓存代理类字段即有CDN;模板建站的基本都有平台自带CDN,直接问服务商「我家站是否经过你们CDN、能否出爬虫日志」最快。
放行训练爬虫会不会有内容风险?
分两类看:搜索爬虫(OAI-SearchBot、Claude-SearchBot、PerplexityBot)决定你在AI搜索里能不能被引用,建议放行;
没有服务器日志权限怎么办?
向建站平台或托管商提工单索要「近30天AI爬虫UA抓取次数与状态码」,这是合理的数据权利;拿不到日志的平台,至少要求确认「是否对主流AI爬虫返回403」。两个都拒绝的平台,本身就是一个换供应商的信号。
403修好后多久能在ChatGPT里看到引用?
以观察窗口口径:先看日志出现200(1–2周),再看引用(最多给到4周)。AI搜索引擎的索引有更新节奏,引用滞后于抓取是正常现象;