ChatGPT 写的 LinkedIn 帖被识破,问题不在用了 AI,而在把默认词句原样发了出去。懂行读者判断一个帖子是不是机器写的,过半看词汇、三成多看句式——这两层都有能直接对照的自查清单,发帖前五分钟可以跑完。
先说一个我们在客户现场看到的场景:业务员上午用 ChatGPT 生成一条产品帖,五分钟发出去,下午同行在评论区留了句「这帖子一股 AI 味」。业务员觉得冤——内容是真的、参数是对的、图是自己拍的,凭什么说一股 AI 味?凭的就是词汇和句式这两层信号:他连 ChatGPT 默认会用的那批词都没换,开头还是那个全世界都在用的句式。
这一篇把「AI 味」拆成词、句、密度三层,给一套能自己跑的自查清单,再讲两个更隐蔽的暴露点和五条建议要反过来的情况。先说边界:本篇的核心数字来自第三方技能包 linkedin-skills 的语音规则清单(媒体实读全文口径,2026-11-09),不是 LinkedIn 官方发布——LinkedIn 官方没有公布过任何「AI 检测权重」,引用时不要说成官方口径。
一、识破的分布:53% 看词汇、36% 看句式
第三方技能包给出的判断分布是:专家读者判断「这是 AI 写的」时,53% 靠词汇、36% 靠句式,剩下归到结构与内容层面。这个分布有两个直接推论。
第一,词汇是大头。你花再多心思排版、配图、调结构,只要那批词还在,暴露就是大概率事件。第二,句式占三分之一,意味着光删词不够——「It's not just X, it's Y」这类句式本身也是信号,换词不换句等于白删。
| 判断层 | 占比 | 典型信号 | 自查动作 |
|---|---|---|---|
| 词汇 | 53% | leverage、facilitate、ecosystem 这类高频 AI 词 | 对照 20 词黑名单逐段扫 |
| 句式 | 36% | 「It's not just X, it's Y」「In today's fast-paced world」 | 对照 5 个套话句式 |
| 结构与内容 | 约 11% | 三段式过于工整、每段等长、缺具体细节 | 看段落密度与事实密度 |
还有一条硬数字值得记住:第三方规则清单认为帖子 900–1,300 字符、评论 200–350 字符是 2026 年信息流的甜点区间。外贸业务员最常见的两个极端——三行产品图帖和一千五百字的小作文——都不在这个区间里。
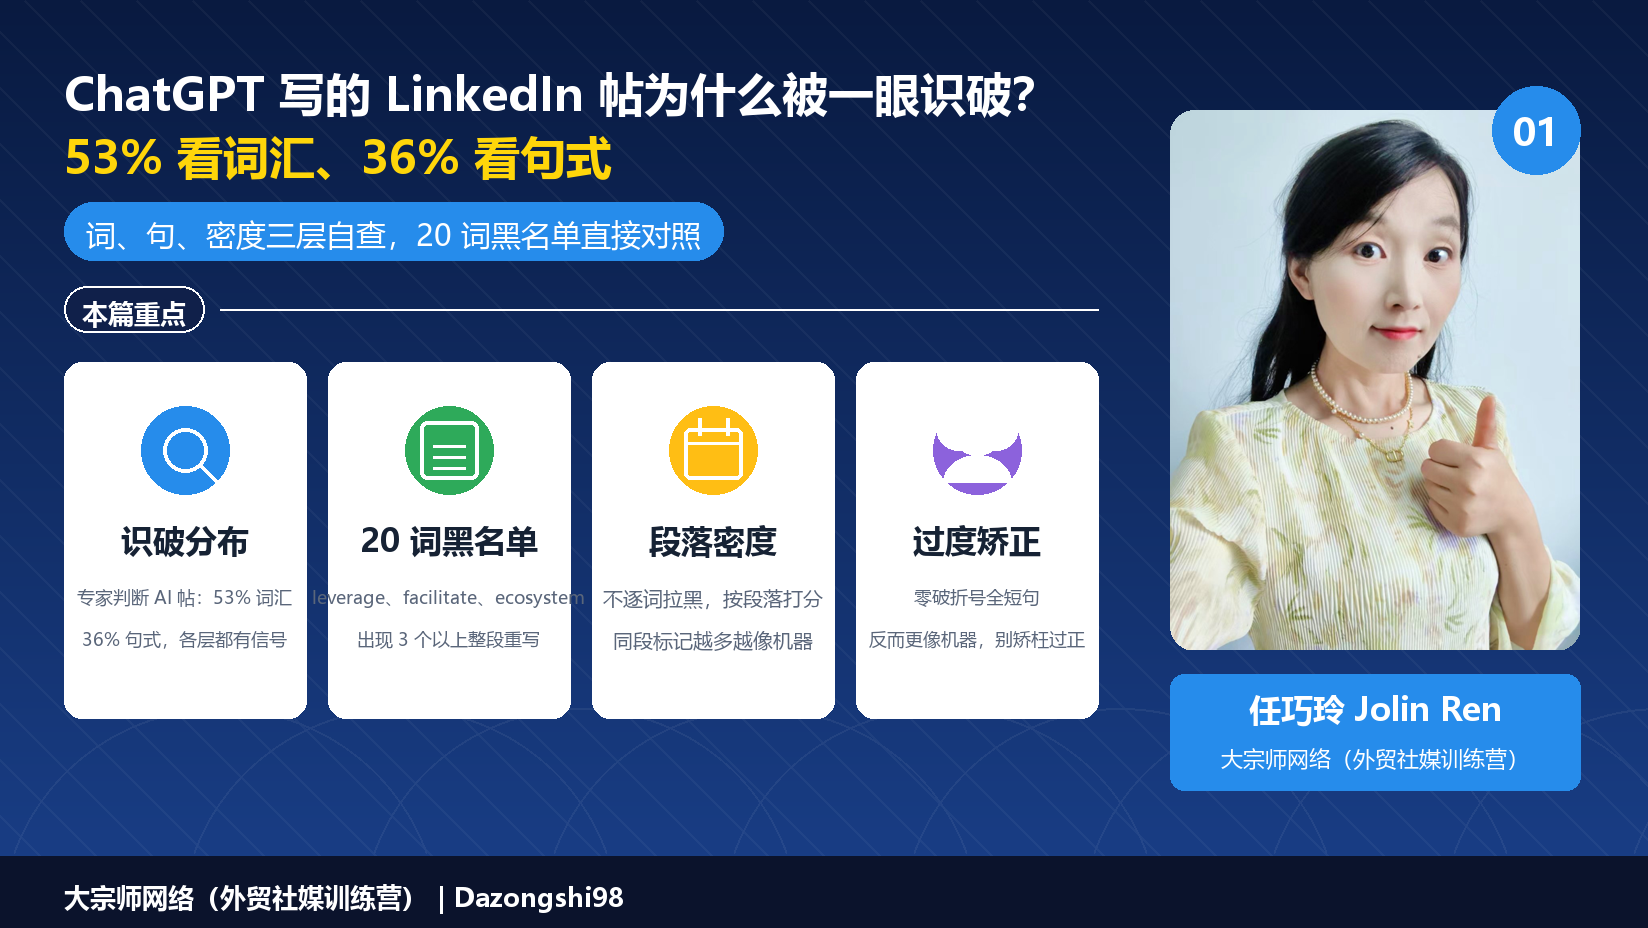
二、20 词黑名单:ChatGPT 最爱用的词,同一段出现三个就整段重写
这份黑名单的完整表如下,全部是 ChatGPT 写英文营销内容时的默认高频词。自查方法不是全局搜索删光,而是按段扫:同一段落里出现 3 个以上,整段重写;只出现一两个,替换即可。
| 分组 | 黑名单词 | 外贸帖里最常见的样子 |
|---|---|---|
| 动词类 | leverage、utilize、facilitate、streamline、harness、foster、cultivate、unlock、navigate | "We leverage advanced technology to facilitate seamless cooperation" |
| 副词与强调类 | fundamentally、essentially、ultimately、crucially、notably | "This is crucially important for your supply chain" |
| 名词隐喻类 | landscape、ecosystem、paradigm、realm、tapestry、journey | "In today's manufacturing landscape…" "Join us on this journey" |
| 形容词类 | robust、seamless | "robust quality control" "seamless delivery" |
对照一下你最近十条帖:如果每条都能圈出两三个,那不是「有点 AI 味」,是整批内容都在用机器的默认词汇。替换不需要找生僻词——把 leverage 换成 use,把 facilitate 换成 help,把 robust 换成具体的「三年抽检不良率 0.8%」这种带数字的说法,词汇层的信号就消掉了大半。
一个提醒:这套规则本身是「规避检测」导向的第三方技能包,我们对外只讲一个方向——让内容读起来像真人。具体数字胜过形容词,客户案例胜过套话,这本身就是最好的替换词库。
三、五个套话句式:比黑名单更早暴露的开头
句式层的信号集中在开头。这五个句式被明确列为高暴露:
- It's not just X, it's Y —— ChatGPT 最爱的「升华句」,真人极少在业务帖里这么写。
- In today's fast-paced world… —— 万能开头,等于告诉读者「下面没有具体信息」。
- Game-changer —— 形容自己的产品几乎不会是真的,读者默认降权处理。
- deep dive —— 培训圈和咨询圈用滥了,B2B 买家看到就想跳过。
- At the end of the day… —— 总结腔,配上三段式结构,整帖的机器感立刻拉满。
还有一条容易被忽略的句式数据:"The result?" 这类自我设问的桥接语,会拉低约 4.8% 的触达(同一第三方口径)。ChatGPT 特别爱用这种「提问—揭晓」的结构制造节奏感,真人业务员写客户现场时基本不会这么写。
四、段落密度打分:不逐词拉黑,按段自查
逐词全局替换有个副作用:把帖子改得干干净净、一个标记词都没有,反而出现了新的机器特征——零破折号、零三连排比、全句等长。规则清单把这叫过度矫正:矫正过头和不做矫正一样,读起来都是机器。
正确的方法是按段落打分,而不是逐词拉黑:
| 段落情况 | 判分 | 处理 |
|---|---|---|
| 全段 0–1 个标记词或句式 | 通过 | 不动 |
| 同段 2 个标记 | 存疑 | 替换其一,读一遍再定 |
| 同段 3 个及以上标记 | 不合格 | 整段重写,不从原句改 |
| 全帖 0 标记但全句等长、无破折号 | 过度矫正 | 刻意留一处长短句差异,加一处自然停顿 |
真人写作的特征恰恰是不完美:句子长短参差、偶尔一个破折号插入补充、有一处只有现场才知道的细节。自查的目标不是「像被洗过」,是「像有个真人在说话」。
五、两个更隐蔽的暴露点:"装真诚"与犹豫语气
词汇和句式之外,还有两类信号更容易漏查。
第一类是「装真诚」。let me be honest、I'll be real、To be honest with you 这类短语,在 AI 生成文本里的出现频率远高于真人写作——模型在模仿「真诚感」,但真人业务员写客户现场时根本不需要宣布自己真诚。第三条暴露点是犹豫语气:规则清单给出的数字是犹豫表达(maybe、I think、perhaps 之类)在 LLM 文本中比人类专家多 2 倍。模型用犹豫语气软化了所有判断,而懂行的人恰恰靠判断的确定性来识别专家。
这一条我们给企业做内容体检时最常见:业务员交上来的帖子里,「可能」「或许」「基本上」密密麻麻,每句话都给自己留退路。删掉这些词,换成「这个配置在我们上个月的订单里是这么配的」,帖子的可信度立刻不同——前提是后面那句必须是真的。
第二类是细节密度。ChatGPT 写不出「上周三那次验货,客户拿卡尺量了第三批的焊缝」这种句子,因为它没有这个素材。词汇可以替换、句式可以打散,没有素材就是没有素材。这就是为什么我们说 AI 味本质上是素材问题——见第七节。
六、LinkedIn 发帖前的五分钟自查:词、句、密度三层
把前面几节收成一个可以执行的顺序。发给客户看的内容,发之前花五分钟过一遍:
| 步骤 | 动作 | 通过标准 |
|---|---|---|
| 1. 词汇扫 | 对照 20 词黑名单扫全文 | 无「同段 3 个以上」,全帖不超过 2–3 处 |
| 2. 句式扫 | 对照 5 个套话句式看开头三行 | 开头是具体场景或具体数字,不是万能句 |
| 3. 密度查 | 按段落打分 | 无整段重写级段落,也无零标记的过度矫正 |
| 4. 确定性查 | 找犹豫语气 | 判断句为主,「可能」类词不超过 1–2 处且都有实际依据 |
| 5. 素材查 | 问一句「这句话只有我们能写吗」 | 至少一处现场细节或具体数字是 AI 编不出来的 |
第五步是核心。前四步是删错的,第五步是验对的——一条没有只有你能写的细节的帖子,哪怕词句全干净,也只是「干净的模板」。
七、大宗师的判断:AI 味是素材问题,不是文字问题
判断一:识破的从来不是 AI,是「没有自己东西的 AI 用法」。 站内此前写过 LinkedIn 三周收到 100 万次 AI Slop 举报那一篇(平台拦的是没人味的内容,不是 AI 辅助本身)。把三条线合起来看:平台层拦的是批量模板,读者层识破的是默认词句,两层指向同一个根源——内容里没有只有你才有的素材。词汇替换能救一条帖,救不了一个长期没有素材的账号。
判断二:对业务员来说,「AI 味」最贵的代价不是丢脸,是丢掉询盘机会。 采购方刷 LinkedIn 的时候也在筛供应商的专业度:一个帖子全是 harness 和 ecosystem,读者得到的信号是「这家公司连发帖都是套模板」。反过来,一条讲「客户为什么总在我们第三批货上挑焊缝问题」的帖,采购看完就知道这家厂真的管过程。帖子是主页的门面,主页是被客户检查的入口——AI 味帖子浪费的不是互动数,是客户点进主页之后那三十秒。
判断三:自查清单的终点是分工,不是文风。 词、句、密度三层自查能保证帖子「不像机器」,但保证不了帖子「值得看」。我们自己在账号上测出来的规律是:凡是让 ChatGPT 直接生成、人只改词的帖子,数据都平庸;凡是业务员先口述现场细节、ChatGPT 负责整理结构的帖子,反而稳定。顺序反过来,结果就反过来——这就是第八节要讲的分工。
八、外贸团队怎么分工:ChatGPT 管整理,询盘与跟进归人
把分工写死,比培训文风技巧更有效:
| 环节 | 交给谁 | 理由 |
|---|---|---|
| 素材提供(客户现场、验货、返工、报价中的细节) | 业务员口述或文字记录 | AI 没有这个素材,编出来的就是幻觉 |
| 结构整理与语言打磨 | ChatGPT(在业务员给的素材上) | 模型擅长把散的素材组织成结构 |
| 词句自查(20 词黑名单、句式、密度) | 发帖人自己,五分钟流程 | 清单是死的,机器和人都能跑,但责任在人 |
| 评论区回复与私信承接 | 业务员本人 | 询盘判断、报价条件、客户意图,AI 不能替 |
| 客户跟进与承诺 | 业务员本人 | 价格、交期、认证这些口径必须人给 |
LinkedIn 官方人员在自家活动上的表述也同向:「AI 只用来提速,不用来出主意」。这套分工的验收方式很简单:抽查最近十条帖,每条至少一处现场细节——抽不出来,说明素材环节断了,回头修流程,不用改文风。
九、什么情况下这套自查要反过来
五条反转条件,满足任何一条,上面的建议要调整:
- 你的读者不是英语母语买家时——黑名单的判断来自专家读者的语感,如果你的目标读者本身是第二语言使用者,他们对「AI 味」的敏感度更低,此时内容的事实密度比词句更重要,自查顺序把第五步提到第一。
- 帖子本身是转述官方数据或行业报告时——转述类内容天然偏结构化,句式工整不算暴露信号,但必须把出处写清楚,否则有另一层可信度问题。
- 账号已有稳定的真人互动记录时——一个评论区一直有真实对话的账号,单条帖子的词句容忍度更高;反之,新账号或互动稀薄的账号,每条帖都在替账号定性,自查从严。
- 内部交流或员工培训场景时——给团队看的帖和给客户看的帖标准不同,内部场景追求效率,不必跑全套五步。
- 平台规则更新之后——这组数字来自第三方技能包的当前口径,不是官方标准;如果你读到这篇时 LinkedIn 已公布了正式的 AI 内容标注或检测规则,以官方为准,本清单降级为参考。
本篇常见问题
ChatGPT 写的帖子到底能不能发?
能发,但不能原样发。按本文顺序:业务员先给素材 → ChatGPT 整理 → 五分钟自查 → 发。第三方口径的数字是词汇占识破原因的 53%——原样发出等于把这 53% 原样交出去;过完清单再发,暴露风险大半已经消掉。
20 个黑名单词要全部记住吗?
不用背,存一张对照表放在发帖流程里即可。真正要形成习惯的是判断标准:同段 3 个以上标记就整段重写。外贸帖最常踩的是动词类(leverage、facilitate、streamline)和形容词类(robust、seamless)这两组,先盯这两组,覆盖率已经过半。
按 900–1,300 字符写,外贸内容够用吗?
够。900–1,300 字符大约是 150–220 个英文单词,正好容纳「一个具体场景 + 一个判断 + 一个数字」。更多内容拆成评论区补充或者下一篇——第三方口径里文档轮播的互动率高于纯文本,长内容更适合做成 6–10 页的文档帖,而不是把帖子撑成小作文。
这些百分比是 LinkedIn 官方数据吗?
不是。53%、36%、2 倍犹豫语气、4.8% 触达影响,全部来自第三方技能包 linkedin-skills 的语音规则清单,经媒体实读全文核对,属于第三方口径。LinkedIn 官方从未公布 AI 检测权重。引用给客户或团队时,说「行业第三方口径」,不要说「平台官方规定」。
怎么快速判断自己账号有没有 AI 味问题?
抽最近十条帖做两件事:一,数每条帖里黑名单词的个数;二,找每条帖里「只有你们公司能写」的细节。十条里黑名单词平均超过两个、细节一条都找不出来,问题就不在文风层,在素材采集层——先把业务员每周一次的现场记录机制建起来,再谈写法。
这类问题我们分三块做:LinkedIn 与 Facebook 海外社媒运营负责帖子格式、评论区承接和互动口径这套地基,AI 实战培训负责把 ChatGPT、WorkBuddy 接进素材整理与内容生产但守住人工判断这一步,外贸 GEO 与独立站负责客户从 LinkedIn 点进官网之后 AI 能不能读对你说的话。分开的原因是它们卡住的位置不同——多数团队的 AI 味问题不是文风问题,是素材没人供、分工没定死。我们自己的账号和站上内容跑的就是这套标准,能点开对照。
想聊你自己的具体业务场景,联系大宗师网络(外贸社媒训练营):微信 Dazongshi98。
本篇常见问题
ChatGPT写的帖子到底能不能发?
能发,但不能原样发。按本文顺序:业务员先给素材→ChatGPT整理→五分钟自查→发。第三方口径的数字是词汇占识破原因的53%——原样发出等于把这53%原样交出去;过完清单再发,暴露风险大半已经消掉。
20个黑名单词要全部记住吗?
不用背,存一张对照表放在发帖流程里即可。真正要形成习惯的是判断标准:同段3个以上标记就整段重写。
按900–1,300字符写,外贸内容够用吗?
够。900–1,300字符大约是150–220个英文单词,正好容纳「一个具体场景+一个判断+一个数字」。
这些百分比是LinkedIn官方数据吗?
不是。53%、36%、2倍犹豫语气、4.8%触达影响,全部来自第三方技能包linkedin-skills的语音规则清单,经媒体实读全文核对,属于第三方口径。LinkedIn官方从未公布AI检测权重。
怎么快速判断自己账号有没有AI味问题?
抽最近十条帖做两件事:一,数每条帖里黑名单词的个数;二,找每条帖里「只有你们公司能写」的细节。