2026 年 11 月 9 日 LinkedIn 工程博客公开了 Feed 的「人—帖匹配」机制:用大模型生成的向量,按七个维度——topic、location、job title、company、industry、seniority、education——把帖子匹配给成员,作为圈外内容(Unconnected Content)的正式来源(官方确认)。这套评估官方叫 AutoEval,单模型评测样本从人工标注 20 条扩到 1,000 条。机制拆解站内已有完整一篇(见 LinkedIn 把帖子推给圈外人:只有几百个联系人,海外买家怎么看到你?)。这篇回答一个更落地的问题:系统按七条打分,那你自己能不能先按同样七条给自己打一次分? 可以——用 ChatGPT 扮演 LinkedIn 的 Feed 模型,把你的主页和帖子喂给它,让它告诉你系统「读到了什么、读不到什么」。这篇文章交付完整的自查 prompt 和使用纪律。
为什么用 ChatGPT 模拟是靠谱的:同构不同物
先立住这个方法的边界,别过度神化。
LinkedIn 的匹配用的是它自家的向量系统,ChatGPT 不是那个模型,模拟结果不等于真实打分——这是第一句要说的实话。但模拟依然有用,原因在「同构」:Feed 匹配读的是你主页的字段文本和帖子正文,判断「这段文本表达的是什么专业语境」;这件事恰恰是大语言模型的通用强项。你让 ChatGPT 按七个维度读你的主页,它读出的语境,和 LinkedIn 的模型读出的语境,方向上高度一致——因为两者读的是同一段文本,而文本的语境是客观的:你的 headline 写没写产品类别,任何模型都读得出来。
真正模拟不了的是打分的权重和分发的概率——那是 LinkedIn 的私有数据。所以这个方法交付的不是「预测曝光」,是「语境体检」:七条维度逐条过,看系统读得到什么、读不到什么。读不到的,就是你要改的。这个定位摆正了,方法就稳了。
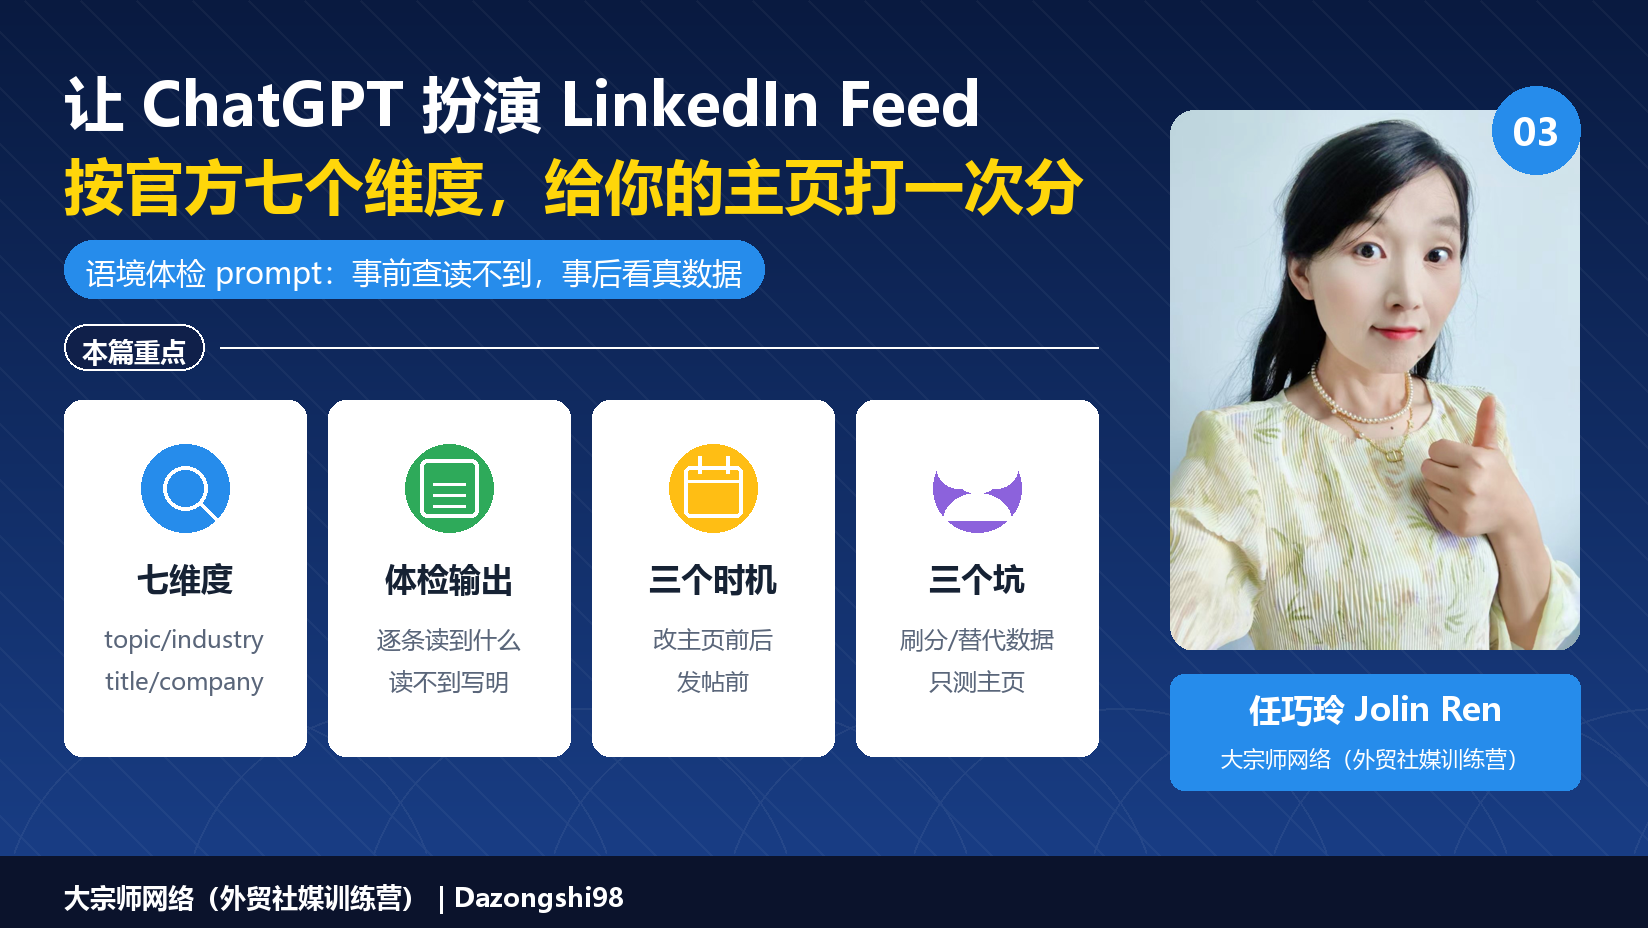
自查 prompt 完整版:直接复制使用
以下 prompt 在 ChatGPT(Gemini、Grok、WorkBuddy 同样可用)里直接粘贴,把括号内容替换成你自己的:
你扮演 LinkedIn Feed 的语境匹配模型。LinkedIn 官方按七个维度把帖子
匹配给圈外成员:topic(话题)、location(地区)、job title(职位)、
company(公司)、industry(行业)、seniority(资历)、education(教育)。

下面是我的 LinkedIn 主页信息和一条待发帖子的正文。请逐条输出:

【主页】
headline:(贴你的 headline)
about 前 3 行:(贴 About 区前三行)
industry:(贴你选的行业)
location:(贴地区)
职位:(贴 title)

【待发帖子】
(贴帖子全文)

输出格式(严格执行):
1. 七维度逐条:系统从上述文本里读到的 [维度] 是什么,用一句话说。
   读不到的写「读不到」,并说明缺了什么信息。
2. 主页与帖子的语境一致性:两者讲的是不是同一件事,不一致处点名。
3. 买家视角测试:一个从没听过我们公司的海外买家读完帖子,
   能不能说出「这家公司做什么产品、服务什么市场」?说出或说不出,都给理由。
4. 最该改的三处:按影响排序,每处给一句改法示例。
不要夸这条帖子,你的任务是扮演挑剔的分发系统。
这个 prompt 的四个输出,正好对应 Feed 匹配的四道关:维度可读性、主页与帖子一致性、买家可理解性、修改优先级。最后一句「不要夸」是关键——默认情况下大模型有恭维倾向,明确关掉它,体检才有效。
七个维度逐条:ChatGPT 会怎么挑你的错
用外贸账号最常见的写法做样例,看体检会查出什么。以下是我们内部测试时的高频结果:
| 维度 | 常见主页写法 | 模拟系统读到 | 缺什么 |
|---|---|---|---|
| topic | 帖子转行业新闻+一句感慨 | 读到新闻主题,读不到你的主题 | 稳定的自有话题线 |
| industry | Manufacturing / Trading Company | 一个大类,无法用于精准匹配 | 细分产品类别 |
| job title | Sales Manager | 一个职能,无产品无市场 | 产品+市场+职责 |
| company | XX Import & Export Co., Ltd | 一个名字 | 公司的出口事实(年限/市场/品类) |
| location | China | 一个国家 | 城市+产业集群(如 Ningbo, Zhejiang) |
| seniority | Owner 或空 | 级别可读,角色不可读 | 你管什么(询盘分配/报价审批) |
| education | 空 | 读不到(权重最低) | 无需硬凑,如实即可 |
七条里前四条(topic/industry/job title/company)是匹配的主食,查出问题优先改;education 是低权重维度,别把精力花在凑学历上。
什么时候用:三个触发时机
体检不是每天做的事,三个时机最划算。
时机一:改主页前后各一次。 改之前跑一次,拿到「读不到」清单;改完再跑一次,验证读到了。两次对比,就是改版效果的自查证据——不靠感觉,靠文本被读出的语境变化。
时机二:重要帖子发布前。 重点是第 2、3 项输出(语境一致性+买家视角)。一条帖子如果让「买家视角测试」不通过——遮住公司名读不出你是做什么的——发出去在圈外分发里就是零语境,等于白发。
时机三:连续两周帖文数据异常时。 圈外曝光占比突然掉了,先跑体检看是不是内容漂了:帖子话题离开了主页写的主业语境,Feed 匹配自然失灵。查出来是内容漂移,收敛话题;查出来是主页被改花了(多人管账号的常见事故),恢复字段。
别踩的三个坑:把模拟用歪的方式
坑一:把体检结果当成绩单刷分。 有人拿到「最该改的三处」就反复改、反复测,把 prompt 当 SEO 老时代的「关键词密度工具」用——反复堆砌「产品类别+市场」直到七条全绿。这是表单时代的手艺。正确的用法是改一轮、跑一次、停:文本自然表达出的语境够了就收手,堆砌在生成式系统里是负信号。
坑二:用体检替代真实数据。 四周后要看真数据:帖文曝光里「非连接成员」占比、评论者里非一度人脉的数量。模拟是事前的,数据是事后的,两者各管一段,不能互相替代。
坑三:只测主页不测帖子。 匹配是双向输入,主页七字段写对了、帖子全是转发海报,照样匹配不到。每次体检把主页和一条真实待发帖一起喂进去,两个输入同时查。
和 ChatGPT 写帖纪律的配合:AI 管草稿,人管证据
这个自查工作流和站内的 AI 写帖纪律是上下游关系。ChatGPT 重组你的素材成帖(上游),再扮演 Feed 模型给帖子体检(下游)——同一个工具,两个角色。纪律不变:AI 产出的草稿要贴回一手细节再发(一个真实公差、一次验厂记录、客户原话脱敏),53% 的读者靠词汇、36% 靠句式识破 AI 味,识破帖子的和匹配语境的读法是同一套(见 ChatGPT 写的 LinkedIn 帖为什么被一眼识破?53% 看词汇、36% 看句式)。
串起来的一周节奏:周三让 ChatGPT 重组素材成帖(贴回细节),发布前跑一次七维度体检(本文的 prompt),周五记录该帖的圈外曝光占比。三步都在 AI 工具流里完成——这就是我们 ChatGPT 培训模块里「AI 多角色工作流」的标准课:同一个模型,写手和考官两个角色分开调用,中间夹着人的一手证据。
大宗师网络的三条判断
第一,自查这件事的本质是「把系统的读法变成你的写法」。 LinkedIn 公开七个维度的价值,不只是解释了分发机制,是给了所有人一份官方的「阅读理解大纲」。照着大纲写,不是取巧,是让内容回到「读者需要什么信息」这个原点——七个维度本来就是买家认识你的七个问题。
第二,模拟工具的价值在事前,数据的价值在事后,别混。 ChatGPT 体检能帮你避免「发出去就注定没语境」的帖子,但预测不了哪条会爆。给它事前的定位,也给数据事后的地位,两个都别越位。
第三,这套体检是 LinkedIn 培训和 ChatGPT 培训的交叉课。 主页七字段是 LinkedIn 线的核心交付,prompt 工作流是 AI 线的核心交付——这篇把两者串成一条。企业内训时,这一课的现场产出就是每个人当场拿到自己的「读不到」清单和改法示例,回去半天改完。
什么时候这个方法帮不上你(反转条件)
- 主页和帖子都是空壳——没有内容喂给体检,先解决「写什么」,再谈「读不读得出」。空账号跑体检没有意义。
- 指望它预测曝光——再强调一次:它做的是语境体检,不是流量预测。用它选「发哪条」,用它算「能有多少曝光」就是用错了工具。
- 中文帖当主力——官方未披露语种覆盖,面向海外买家仍以英文帖为主力,体检也主要测英文内容(见圈外分发机制文的语种口径)。
- 一个月发不到 4 条——分发机制需要内容样本量,先解决节奏,再优化单条质量。体检再准,也救不了月更账号。
常见问题
prompt 用中文写,测英文内容行不行?
行。ChatGPT 处理中文指令+英文内容的混合输入没有障碍,输出让它给中文(你读着改)或英文(贴给外籍同事)都行。Gemini、Grok、WorkBuddy 同样支持这个用法。
七个维度里 education 真的可以不管吗?
官方未公布各维度权重,我们按「信息密度」原则推断:topic、industry、job title、company 四条承载的匹配信息远多于 education。实践口径:education 如实填、不硬凑,精力花在前四条。这是经验判断,不是官方口径,标注在这。
体检发现主页和帖子不一致,先改哪个?
先改主页。主页是一次性工程(改一次管一年),帖子是每周工程。主页锚点错了,每条帖子都在漂——先锚后帆。
团队五个人都用这个 prompt,会不会被判定 AI 代写?
不会。这个 prompt 的产出是「给你的反馈」,不是「替你发的内容」——发布的内容仍然是你贴回一手细节后的版本。工具参与的是质检环节,这与平台对 AI 生成内容标注的口径不冲突(见 平台开始给 AI 写的帖子打标签了:外贸团队用 ChatGPT 写帖,要留什么证据?)。
没有付费版 ChatGPT,免费版能跑吗?
能。这个 prompt 不依赖高级模型能力,免费版的语境理解就够用。企业内训场景下,WorkBuddy 里建一个自查技能卡固化这段 prompt,团队人人可用——这也是我们 WorkBuddy 培训线的标准交付之一。
本文属于我们 LinkedIn 培训 与 AI 外贸智能体培训(ChatGPT) 两条线:主页工程、语境自查工作流。训练营把「七维度自查 prompt」作为 LinkedIn 模块和 AI 工具模块的共用交付物——不承诺圈外曝光数字,交付的是让系统读得出你的那套自查方法。
想聊你自己的具体业务场景,联系大宗师网络(外贸社媒训练营):微信 Dazongshi98。
本篇常见问题
prompt用中文写,测英文内容行不行?
行。ChatGPT处理中文指令+英文内容的混合输入没有障碍,输出让它给中文(你读着改)或英文(贴给外籍同事)都行。Gemini、Grok、WorkBuddy同样支持这个用法。
七个维度里education真的可以不管吗?
官方未公布各维度权重,我们按「信息密度」原则推断:topic、industry、jobtitle、company四条承载的匹配信息远多于education。
体检发现主页和帖子不一致,先改哪个?
先改主页。主页是一次性工程(改一次管一年),帖子是每周工程。主页锚点错了,每条帖子都在漂——先锚后帆。
团队五个人都用这个prompt,会不会被判定AI代写?
不会。这个prompt的产出是「给你的反馈」,不是「替你发的内容」——发布的内容仍然是你贴回一手细节后的版本。
没有付费版ChatGPT,免费版能跑吗?
能。这个prompt不依赖高级模型能力,免费版的语境理解就够用。